觀察式記憶體
新增於: @mastra/memory@1.1.0
觀察式記憶體(Observational Memory,OM)是 Mastra 專為長上下文 Agent 記憶打造的記憶體系統。兩個背景 Agent——Observer 與 Reflector——會監看 Agent 的對話,並維護一份密集的觀察紀錄,隨著對話增長取代原始訊息歷史。
快速開始「快速開始」的直接連結
請確認專案已安裝 @mastra/memory。在 Memory 設定中指定 observationalMemory: true,即可啟用觀察式記憶體。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
Agent 現在具備類似人類、可跨對話持續保存的長期記憶。設定 observationalMemory: true 時,預設使用 google/gemini-2.5-flash。若要使用其他模型,請在設定物件中傳入模型:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
完整 API 詳情請參閱設定選項。
在用戶端應用程式中使用 OM 時,用戶端應只傳送新訊息,不要傳送完整對話歷史。
觀察式記憶體仍依賴已儲存的對話歷史。傳送完整歷史不但多餘,當用戶端時間戳記與已儲存的時間戳記衝突時,還可能造成訊息順序錯誤。
AI SDK 範例請參閱使用 Mastra Memory。
OM 目前只支援 @mastra/pg、@mastra/libsql、@mastra/mysql、@mastra/mongodb、@mastra/convex 與 @mastra/oracledb storage adapter。
它使用背景 Agent 管理記憶體。未設定模型時,預設模型為 google/gemini-2.5-flash。
時間間隔標記「時間間隔標記」的直接連結
當 thread 中前後兩則訊息相隔足夠長的時間,時間間隔標記會在新的使用者訊息前插入一段簡短提醒,協助 Agent 與 UI 看出對話是在一段具意義的停頓後恢復。
時間間隔標記預設關閉。在 observationalMemory 設定中指定 temporalMarkers: true 即可啟用:
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
當間隔至少達 10 分鐘時,Mastra 會插入時間間隔標記。此標記會儲存在記憶體中,也會以暫時提醒事件的形式發出,讓用戶端能將它呈現為簡潔的時間軸提示。
Observer 處理 thread 時也會看到這些標記,因此寫入觀察結果時,可將記憶連結至事件發生的時間(例如:「使用者在相隔 2 天後詢問部署相關問題」)。
完整設定結構請參閱 API 參考。
提前啟用「提前啟用」的直接連結
OM 可在達到 token 閾值前啟用已緩衝的觀察結果。當 prompt cache 可能即將到期,或 Agent 更換 model provider 時,這項功能很實用。
頂層提前啟用設定預設套用於觀察階段:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
若要分別控制各階段,請使用巢狀的 observation 與 reflection 設定。reflection 的提前啟用必須明確選擇,因此頂層設定只影響 observation。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
在此範例中,observation 會停用頂層的閒置設定,而 reflection 則選擇啟用閒置與 Provider 變更觸發機制。
閒置時緩衝「閒置時緩衝」的直接連結
將 observation.bufferOnIdle 設為 true,即可在 Agent 回合結束並進入閒置狀態時,於背景執行 observation 緩衝。若應用程式希望短回合也能被觀察,而不必等待下一個回合或達到 messageTokens 閾值,這項設定很實用。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle 預設關閉,且與 bufferTokens 分開運作:bufferTokens 控制步驟執行期間的非同步緩衝,bufferOnIdle 則控制閒置回合在回合結束時的緩衝。
完整設定結構請參閱 API 參考。
優點「優點」的直接連結
- Prompt caching:OM 的上下文保持穩定,觀察結果會隨時間附加,而不是每個回合都在執行階段擷取。這讓 prompt 前綴可被快取,進而降低成本。
- 壓縮:原始訊息歷史與 Tool 結果會壓縮成密集的觀察紀錄。上下文越小,回應越快,對話也能在更長時間內保持連貫。
- 避免上下文劣化:Agent 看到的是相關資訊,而不是雜亂的 Tool 呼叫與無關 token,因此在長時間工作階段中仍能專注於任務。
運作方式「運作方式」的直接連結
你不會記得一生中每段對話的每一個字。你會下意識觀察發生的事情,接著大腦進行反思、重整、合併並濃縮成長期記憶。OM 的運作方式也相同。
每次 Agent 回應時,都會看到一個包含 system prompt、近期訊息歷史及任何注入上下文的上下文視窗。上下文視窗容量有限;即使 token 上限很高的模型,在視窗塞滿時表現也會變差。這會造成兩個問題:
- 上下文劣化:Agent 攜帶的原始訊息歷史越多,表現就越差。
- 上下文浪費:大部分歷史都包含已不再需要用來維持 Agent 任務焦點的 token。
OM 會將舊上下文壓縮成密集的觀察結果,同時解決這兩個問題。
觀察結果「觀察結果」的直接連結
當訊息歷史的 token 超過閾值(預設為 30,000)時,Observer 會建立簡潔記錄事情經過的觀察結果:
OM 會使用快速的本機 token 估算來判斷此閾值。文字透過 tokenx 估算,圖片部分則使用會感知 Provider 的啟發式方法,讓多模態對話仍能在正確時機觸發 observation。當傳輸層將上傳的圖片正規化成 file 而非 image 部分時,類圖片的 file 部分也採用相同做法。例如,OpenAI 圖片詳細程度設定可能會實質改變 OM 決定執行 observation 的時間。
Observer 也能看到所檢閱歷史中的附件。為維持逐字稿的可讀性,OM 會保留 [Image #1: reference-board.png] 或 [File #1: floorplan.pdf] 等易讀的預留位置,並將實際附件部分連同文字一起轉送。可行時,類圖片的 file 部分會升級為 Observer 的圖片輸入;非圖片附件則以 file 部分轉送,並採用正規化的 token 計數。這同時適用於一般 thread observation 與批次 resource scope observation。
Extractor「Extractor」的直接連結
若要讓 OM 在觀察結果旁保存特定值,請使用 extractor。目前任務、建議回應和 thread 標題等內建值,與自訂值使用相同的擷取管線。
以下範例會從觀察結果擷取精簡的使用者個人資料:
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
加入 schema 後,extractor 會以後續的結構化輸出請求執行。沒有 schema 的 extractor 則是行內字串 extractor,直接在 Observer 或 Reflector 回應中輸出。
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
OM 預設會在後續執行時,向 extractor 顯示上次擷取的值。當 Observer 不應看到先前值時,請設定 includePreviousExtraction: false。
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
當 extractor 需要執行階段上下文(例如目前的 memory 執行個體或 request context)時,請使用執行階段 instructions 或 schema 函式:
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
從串流讀取擷取值「從串流讀取擷取值」的直接連結
OM 完成 observation 或 reflection 時會發出 extractor 結果。請從串流讀取這兩種完成資料部分:
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues 以各 extractor 的 slug 為鍵。兩個結果欄位皆為選填,且 extractor 失敗不會移除其他 extractor 成功擷取的值。
data-om-observation-end 代表同步完成;data-om-buffering-end 代表背景工作完成。後者的 extractor metadata 會立即保存,但緩衝內容在啟用前仍不生效。檢查 operationType 即可判斷完成的工作是 observation 或 reflection。
完整 payload 請參閱 data-om-observation-end 與 data-om-buffering-end 參考表。
更新工作記憶體「更新工作記憶體」的直接連結
使用 observationalMemory.observation.manageWorkingMemory,即可讓 Observer 自動管理工作記憶體。主要 Agent 處理使用者要求時不再需要呼叫工作記憶體 Tool,因此更新不會依賴 Agent 是否記得呼叫 Tool。
這也讓工作記憶體更適合 prompt cache。工作記憶體通常位於 system prompt 中,因此更新可能使 prompt cache 失效。由 OM 管理的工作記憶體會將 workingMemory.useStateSignals 預設為 true,改為把工作記憶體移入 state signal。
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
此設定會加入 WorkingMemoryExtractor、將 workingMemory.agentManaged 預設為 false,並將 workingMemory.useStateSignals 預設為 true。若主要 Agent 仍應接收工作記憶體 Tool 與指示的注入,請設定 workingMemory.agentManaged: true。
使用 onExtracted,可在自訂擷取值保存前進行正規化或回應:
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
Extractor 失敗會記錄於 OM 標記中,且不會阻擋其他 extractor 成功擷取的值。完整 Extractor 結構請參閱 API 參考。
若 Observer 模型僅支援文字,或其 API 拒絕多模態輸入,請將 observation.observeAttachments 設為 false,在附件抵達 Observer 前將其捨棄。逐字稿仍會保留易讀的預留位置([Image #1: ...]、[File #1: ...]),因此 Observer 即使沒有收到二進位 payload,仍可推斷分享過哪些內容。相同篩選條件也適用於含有 image 或 file 部分的 Tool 結果:
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
你也可以傳入 mimeType glob 的允許清單(例如 ['image/*']),只轉送 Observer 能處理的類型。或者將 observeAttachments: 'auto' 設為由 Mastra 根據 Provider capability registry 決定:Observer 模型支援多模態輸入時轉送附件,否則捨棄;若沒有該模型的 capability 資料,則退回使用 true。
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
壓縮率通常介於 5 倍到 40 倍。Observer 也會追蹤目前任務與建議回應,讓 Agent 能從上次中斷處繼續。
若啟用 observation.threadTitle,Observer 也能在對話主題發生實質變化時建議簡短的 thread 標題。thread 標題產生功能必須明確啟用,並會更新 thread metadata,因此 Mastra Code 等應用程式可在 thread 清單與狀態 UI 中顯示最新標題。
例如,使用 Playwright MCP 的 Agent 可能會在每個頁面快照看到超過 50,000 個 token。透過 OM,Observer 會監看互動,並以數百個 token 記錄頁面內容與已執行動作。Agent 不必攜帶每份原始快照,也能持續專注於任務。
反思「反思」的直接連結
當觀察結果超過閾值(預設 40,000 個 token)時,Reflector 會濃縮內容、合併相關項目,並對模式進行反思。
reflection 不會累積成另一個持續增長的獨立層。每次 reflection 都會重寫整份觀察紀錄;Reflector 的輸出會成為新紀錄,之後再附加新的觀察結果。當紀錄下次達到閾值時,Reflector 會重新處理所有內容,包括先前的 reflection。它會更積極地濃縮舊資訊,同時保留近期細節。無論對話持續多久,記憶體大小都會維持在 reflection 閾值附近。
最終形成三層系統:
- 近期訊息:目前任務的精確對話歷史
- 觀察結果:Observer 所見內容的紀錄
- 反思結果:記憶過長時濃縮後的觀察結果
上下文如何隨時間變化「上下文如何隨時間變化」的直接連結
使用預設設定時,上下文視窗不會無限制增長,而會在「觀察後縮減」的循環中變動:
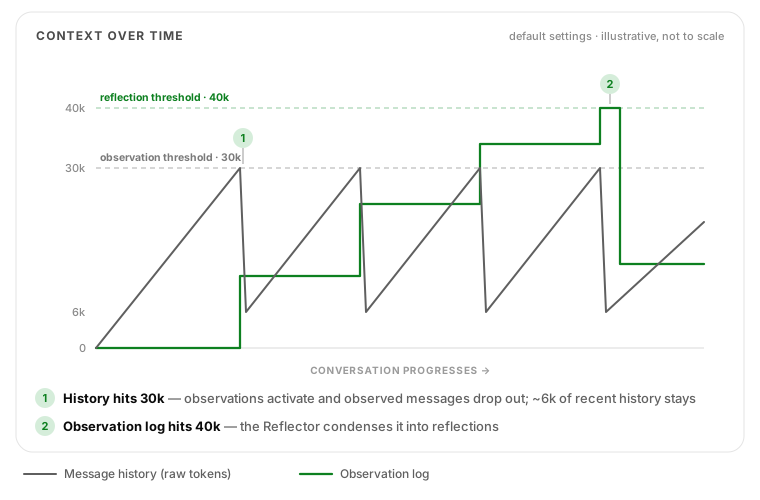
- 0 → 30k token:訊息歷史正常增長。Observer 會在背景中約每累積 ~6k token(
bufferTokens: 0.2)緩衝一次觀察結果。 - 達到 30k:已緩衝的觀察結果立即啟用。已觀察的訊息會從上下文視窗移除,只留下約 ~6k token 的近期歷史(
bufferActivation: 0.8會保留閾值的 20%)。在常見的 5 至 40 倍壓縮率下,被移除的 ~24k token 訊息會轉成約 1–5k token 的觀察結果。 - 重複:歷史從 ~6k 再次朝 30k 增長,之後再縮減。每次循環都會附加至觀察紀錄,而觀察紀錄的增長速度遠低於原始歷史。
- 觀察結果達到 40k:Reflector 會根據目前觀察結果與任何先前 reflection 建立較小的紀錄。
在一般緩衝循環中,原始歷史會在約 6k 至 30k token 之間變動。無論對話持續多久,觀察紀錄都會維持在約 40k token。這些數字是啟用閾值,不是硬性上限。若背景緩衝跟不上,歷史可能超過閾值,直到 blockAfter(預設 1.2)在約 ~36k token(reflection 約 ~48k)強制進行同步 observation,作為安全上限。
啟用 shareTokenBudget 後,兩個額度會合併共用。當觀察紀錄較小時,訊息歷史可使用尚未占用的 observation 空間(預設最多約 ~70k token),之後才觸發 observation。隨著觀察結果累積,訊息歷史便會縮減。
擷取模式「擷取模式」的直接連結
一般 OM 會將訊息壓縮成觀察結果,很適合維持任務焦點,但原始措辭會消失。擷取模式會讓每組觀察結果保持與其來源原始訊息的連結,解決此問題。當 Agent 需要摘要中已被壓縮掉的精確措辭、Tool 輸出或時間順序時,可呼叫 recall Tool 分頁查看來源訊息。
僅瀏覽「僅瀏覽」的直接連結
設定 retrieval: true 即可啟用 recall Tool 來瀏覽原始訊息,不需要 vector store。recall Tool 預設可瀏覽目前 resource 的所有 thread。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
搭配語意搜尋「搭配語意搜尋」的直接連結
設定 retrieval: { vector: true } 還可啟用語意搜尋。此功能會重複使用 Memory 執行個體上已設定的 vector store 與 embedder:
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
設定向量搜尋後,新的觀察結果群組會在緩衝時及同步 observation 期間自動建立索引(射後不理、不阻塞)。語意搜尋會傳回觀察結果群組的相符項目,以及其原始來源訊息 ID 範圍,讓 recall Tool 能同時顯示摘要記憶與來源位置。
限制於目前 thread「限制於目前 thread」的直接連結
recall Tool 的預設 scope 為 'resource',Agent 可列出 thread、瀏覽其他 thread,並搜尋所有對話。設定 scope: 'thread' 可將 Agent 限制為只能存取目前 thread:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
自訂 recall 指引「自訂 recall 指引」的直接連結
Mastra 會注入可感知 scope 的指示,教導 Agent 何時應搜尋、列出 thread 或讀取特定 thread。使用 instructions 可在這些內建指示後附加應用程式專屬指引;內建指示永遠不會被取代:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
如此可讓 recall 專屬指引附加在 recall Tool 上,而非 Agent 的全域指示,因此不會影響無關任務。
擷取模式提供的功能「擷取模式提供的功能」的直接連結
啟用擷取模式後,OM 會:
- 在每個觀察結果群組上儲存指向來源訊息的
range(例如startId:endId) - 在 Agent 上下文中保留可見的 range metadata,讓 Agent 知道各觀察結果對應哪些訊息
- 註冊 Agent 可呼叫的
recallTool,用於:- 分頁瀏覽任何觀察結果群組 range 背後的原始訊息
- 依語意相似度搜尋(
mode: "search"搭配query字串);需要vector: true - 列出所有 thread(
mode: "threads")、瀏覽其他 thread(threadId),以及搜尋所有 thread(預設scope: 'resource') - 當
scope: 'thread'時:只允許瀏覽與搜尋目前 thread
完整 API(詳細程度、part 索引、分頁、跨 thread 瀏覽與 token 限制)請參閱 recall Tool 參考。
Studio「Studio」的直接連結
若要查看實際運作方式,請開啟 Studio,並前往已啟用 OM 的 Agent。Memory 分頁會顯示:
-
Token 進度列:目前訊息與觀察結果的 token 數量,以及各自距離閾值還有多遠。將游標停在資訊圖示上,即可查看 Observer 與 Reflector 使用的模型和閾值。
-
生效中的觀察結果:目前觀察紀錄會直接顯示。若有較早的 observation 或 reflection 紀錄,可展開「Previous observations」瀏覽。
-
背景處理:對話期間,Agent 在背景處理時會顯示已緩衝的 observation 區塊與 reflection 狀態。
Agent 執行 observation 或 reflection 時,進度列會即時更新,顯示經過時間與狀態徽章。
模型「模型」的直接連結
Observer 與 Reflector 會在背景執行。任何支援 Mastra 模型路由(provider/model)的模型都可使用。未設定模型時,預設模型為 google/gemini-2.5-flash。
Mastra 建議使用上下文視窗較大(128K+ token),且速度足以在背景執行、不拖慢操作的模型。
若不確定該使用哪個模型,可從預設的 google/gemini-2.5-flash 開始。我們也成功測試過 openai/gpt-5-mini、anthropic/claude-haiku-4-5、deepseek/deepseek-reasoner、deepseek/deepseek-v4-pro、deepseek/deepseek-v4-flash、xai/grok-4-1-fast、qwen3 與 glm-4.7。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
若要為每個 Agent 使用不同模型,請參閱模型設定。
google/gemini-2.5-flash 特別擅長在長輸出中保留細節。因此,即使已達最大壓縮重試次數,Reflector 產生的 reflection 仍可能高於設定的 reflection.observationTokens 閾值。發生這種情況時,Reflector 會傳回重試期間產生且未失真的最小候選結果,讓迴圈終止而不會無限執行。
若希望 Reflector 更積極壓縮,請換用較容易濃縮內容的模型,例如 xai/grok-4-1-fast、deepseek/deepseek-v4-pro 或 deepseek/deepseek-v4-flash。Observer 可繼續使用 google/gemini-2.5-flash,Reflector 則使用其他模型。請參閱每個 Agent 使用不同模型。
依 token 分級選擇模型「依 token 分級選擇模型」的直接連結
新增於: @mastra/memory@1.10.0
你可以使用 ModelByInputTokens,依輸入 token 數量為 Observer 或 Reflector 指定不同模型。OM 會在執行階段依設定的 upTo 閾值選擇相符的模型層級。
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
upTo 的鍵是包含該值的上限。OM 會計算 Observer 或 Reflector 呼叫的實際輸入 token 數量,直接解析相符層級,並在該次執行中使用具體模型。
若輸入超過設定的最大閾值,系統會擲回錯誤。請確保閾值涵蓋所有可能的輸入大小,或在最高層級使用上下文視窗足夠大的模型。
Scope「Scope」的直接連結
Thread scope(預設)「Thread scope(預設)」的直接連結
每個 thread 都有自己的觀察結果。此 scope 已經過充分測試,適合作為通用記憶體系統,尤其適合長時間運作的 Agent 使用情境。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
呼叫 Agent 時,thread scope 必須提供有效的 threadId。若缺少 threadId,觀察式記憶體會擲回錯誤。這可避免多個 thread 在無提示的情況下共用同一筆 observation 紀錄,進而造成資料庫死結。
Resource scope(實驗性)「Resource scope(實驗性)」的直接連結
同一 resource(通常是一位使用者)的所有 thread 會共用觀察結果,因而支援跨對話記憶。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'resource',
    },
  },
})
Resource scope 可以運作,但目前仍標示為實驗性,直到我們證實它能在多個同時進行的 thread 之間保持任務遵循與連續性。 現階段你可能需要調整 system prompt,避免某個 thread 接續另一個已開始但尚未完成的工作。
原因在於 resource scope 中,每個 thread 都是同一 resource 所有 thread 的其中一個視角。
這對你的使用情境未必是問題,實際效果可能因情況而異。
在 resource scope 中,會一起處理所有 thread 尚未觀察的訊息。對已有大量 thread 的使用者而言,這可能很慢。既有應用程式請使用 thread scope。
Token 額度「Token 額度」的直接連結
OM 會使用 token 閾值決定何時進行 observation 與 reflection。詳情請參閱 token 額度設定。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
Token 計數快取「Token 計數快取」的直接連結
OM 會將 token 估算快取於訊息 metadata,減少檢查閾值與決定緩衝時重複計數的工作。
- 每個 part 的估算會儲存在
part.providerMetadata.mastra,之後若快取版本與 tokenizer 來源相符便會重複使用。 - 若訊息內容只有字串(沒有 part),OM 會改用訊息層級的 metadata 備援快取。
- 每次仍會重新計算訊息與對話的額外開銷。快取只儲存 payload 估算,因此計數語意保持不變。
data-*與reasoningpart 仍會略過,也不會快取。
呼叫端為 file part 提供 token 估算「呼叫端為 file part 提供 token 估算」的直接連結
你可以透過 providerMetadata.mastra.tokenEstimate,直接在 image 或 file part 上附加 token 估算。Token Counter 會原樣採用此值,略過本身的估算器:
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
tokenEstimate 物件與 Token Counter 內部快取估算使用相同結構:
v:快取 schema 版本,請設為0。呼叫端提供的項目不受 framework 版本檢查限制,因此不會讀取此值。source:快取來源標記,必須為'client'。Token Counter 會由此判斷該項目具權威性,應原樣採用,而非重新計算或覆寫。key:內容 fingerprint 欄位,請設為'client'。framework 項目在此使用內容雜湊,因此 payload 改變時會失效;'client'sentinel 可讓呼叫端估算在寫入後維持穩定。tokens:要使用的 token 數量,必須是有限的非負數。
其他注意事項:
- 估算只會套用於
image與filepart。text與tool-invocationpart 一律正常計數,即使帶有tokenEstimate也是如此。
非同步緩衝「非同步緩衝」的直接連結
若沒有非同步緩衝,達到訊息閾值時 Observer 會同步執行,Agent 會在對話中途暫停,直到 Observer 的 LLM 呼叫完成。使用非同步緩衝(預設啟用)時,觀察結果會隨對話增長在背景預先計算。達到閾值後,已緩衝的觀察結果會立即啟用,不會造成停頓。
運作方式「運作方式」的直接連結
隨著 Agent 對話,訊息 token 會持續累積。每隔固定區間(bufferTokens),系統會在背景呼叫 Observer,且不阻塞 Agent。每次呼叫會產生一個觀察結果「區塊」,儲存在緩衝區中。
當訊息 token 達到 messageTokens 閾值時,緩衝區塊會啟用:其中的觀察結果移入生效中的觀察紀錄,對應的原始訊息則從上下文視窗移除。Agent 完全不會暫停。
緩衝的觀察結果也包含延續提示、建議的下一則回應與目前任務,因此啟用後即使上下文視窗縮小,主要 Agent 仍可維持對話連續性。
若 Agent 產生訊息的速度超過 Observer 的處理速度,blockAfter 安全閾值會在最後手段下強制執行同步 observation。緩衝啟用仍會保留最低限度的剩餘上下文(約 ~1k token 或設定的保留底線,取較小者)。
Reflection 的運作方式相似:當觀察結果達到 reflection 閾值的一定比例時,Reflector 會在背景執行。
設定「設定」的直接連結
| 設定 | 預設值 | 控制項目 |
|---|---|---|
observation.bufferTokens | 0.2 | 緩衝頻率。0.2 表示每達 messageTokens 的 20% 緩衝一次。預設閾值為 30k 時,約每 6k token 一次。也可使用絕對 token 數量(例如 5000)。 |
observation.bufferActivation | 0.8 | 啟用時清除訊息視窗的積極程度。0.8 表示移除足夠訊息,只保留 messageTokens 的 20%。較低值會保留更多訊息歷史。 |
observation.blockAfter | 1.2 | 緩衝跟不上時的安全機制。從 1 到小於 100 的值會乘以 messageTokens:使用 1.2 時,會在 36k token(1.2 × 30k)強制同步 observation。100 以上則代表絕對 token 數量(例如 50_000)。 |
activateAfterIdle | 無 | 即使尚未達到 observation.messageTokens,也會在閒置一段時間後強制啟用緩衝的觀察結果。接受毫秒數值(如 300_000)、"5m" 或 "1hr" 等期間字串,或依 Provider prompt cache TTL 決定的 "auto"。 |
activateOnProviderChange | false | 當下一步使用的 provider/model 與產生最新 assistant 步驟者不同時,強制啟用緩衝的觀察結果。若切換 Provider 或模型會使 prompt cache 無法重複使用,請啟用此設定。 |
reflection.bufferActivation | 0.5 | 開始背景 reflection 的時機。0.5 表示觀察結果達到 observationTokens 閾值的 50% 時開始 reflection。 |
reflection.activateAfterIdle | 無 | 選擇讓緩衝的 reflection 在閒置時啟用。Reflection 不會繼承頂層 activateAfterIdle。 |
reflection.activateOnProviderChange | false | 選擇讓緩衝的 reflection 在 Provider 變更時啟用。Reflection 不會繼承頂層 activateOnProviderChange。 |
reflection.blockAfter | 1.2 | Reflection 的安全閾值,邏輯與 observation 相同。 |
若依賴 prompt caching,請將 activateAfterIdle 設為 "auto" 或特定 cache TTL。如此一來,thread 閒置時間長到快取過期後,下一個請求可先啟用緩衝的觀察結果,再傳送較小的壓縮上下文視窗。
使用 "auto" 時,Mastra 會依使用中的 model provider 選擇閒置啟用 TTL:
| Provider | 自動 TTL |
|---|---|
| Anthropic、OpenRouter、未知 Provider、xAI | 5 分鐘 |
| DeepSeek | 1 小時 |
| Google Gemini | 24 小時 |
| Groq | 2 小時 |
設為 providerOptions.openai.promptCacheRetention: "24h" 的 OpenAI | 1 小時 |
設為 providerOptions.openai.promptCacheRetention: "in_memory" 的 OpenAI | 5 分鐘 |
OpenAI gpt-4*、gpt-5、gpt-5-*,以及 gpt-5.1 至 gpt-5.4(包括帶有 - 後綴的變體) | 5 分鐘 |
| 其他 OpenAI 模型 | 1 小時 |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
使用 "auto" 時,系統會根據目前 Provider 的 prompt cache 行為啟用緩衝的觀察結果,讓下一個未快取的 prompt 使用壓縮觀察結果,而非較大的原始訊息視窗。若偏好固定 5 分鐘 TTL,請使用 "5m" 或 300_000。
在 thread 中途更換模型或 Provider 會使 prompt cache 失效。若 Agent 可能在 thread 中途切換 Provider 或模型,activateOnProviderChange: true 會在新 Provider 執行前強制啟用緩衝的觀察結果,避免將大型原始視窗傳送給無法重複使用先前 prompt cache 的 Provider。
停用「停用」的直接連結
若要停用非同步緩衝,改用同步 observation/reflection:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
設定 bufferTokens: false 會同時停用 observation 與 reflection 的非同步緩衝。完整 API 請參閱非同步緩衝設定。
非同步緩衝不支援 scope: 'resource',在 resource scope 中會自動停用。
Observer 上下文最佳化「Observer 上下文最佳化」的直接連結
Observer 處理新訊息時,預設會接收完整觀察歷史作為上下文。Observer 也會接收先前的 current-task 與 suggested-response metadata(若有),因此即使觀察上下文遭到截斷,仍能掌握方向。對於長時間執行、觀察結果已大幅增長的對話,你可以啟用上下文最佳化來降低 Observer 輸入成本。
設定 observation.previousObserverTokens 可限制傳送給 Observer 的先前觀察結果 token 數量。系統會從尾端保留最新項目並截斷觀察結果。若有緩衝中的 reflection 等待處理,套用截斷前,已反思的行會自動以 reflection 摘要取代。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: 2000→ 預設值,保留約 ~2k token 的近期觀察結果。previousObserverTokens: 0→ 完全省略先前觀察結果。previousObserverTokens: false→ 停用截斷,保留完整的先前觀察結果。
移轉現有 thread「移轉現有 thread」的直接連結
不需要手動移轉。OM 會讀取現有訊息,並在超過閾值時延遲觀察。
- Thread scope:thread 首次超過
observation.messageTokens時,Observer 會處理累積的訊息。 - Resource scope:同一 resource 所有 thread 中尚未觀察的訊息會一起處理。對已有大量 thread 的使用者而言,這可能需要很長時間。
比較 OM 與其他記憶體功能「比較 OM 與其他記憶體功能」的直接連結
- 訊息歷史:目前對話的高保真紀錄
- 工作記憶體:用於使用者偏好、名稱與目標的小型結構化狀態(JSON 或 markdown)
- 語意回憶:以 RAG 為基礎,擷取相關過往訊息
- 多使用者 thread:多人共用單一 thread 時,OM 如何將事實歸屬於個別使用者
若使用工作記憶體儲存會隨時間增長的對話摘要或持續狀態,OM 更為合適。工作記憶體適用於小型結構化資料,OM 則適用於長時間運作的事件紀錄。OM 也會自動管理訊息歷史;messageTokens 設定可控制執行 observation 前保留多少原始歷史。
實務上,OM 同時取代工作記憶體與訊息歷史,而且準確度比 Semantic Recall 更高、成本也更低。
相關資源「相關資源」的直接連結
- 觀察式記憶體參考
- Memory 概覽
- 訊息歷史
- Memory Processor
- Mastra Code:使用觀察式記憶體的 coding Agent
- 📹 Mastra processor 與觀察式記憶體工作坊