의미적 회상
친구에게 지난 주말에 무엇을 했는지 묻는다면, 그들은 기억 속에서 "지난 주말"과 관련된 사건을 검색한 다음 자신이 무엇을 했는지 말해 줄 것입니다. 이는 Mastra에서 의미적 회상이 작동하는 방식과 비슷합니다.
:::tip[📹 보기]
보다Mastra semantic recall 에서 Agent가 과거 대화에서 관련 메시지를 검색하는 방식을 확인하세요.
:::
의미적 회상이 작동하는 방식의미적 회상이 작동하는 방식에 대한 직접 링크
의미적 회상은 메시지가 더 이상 내부에 없을 때 Agent가 더 긴 상호 작용에서 컨텍스트를 유지하는 데 도움이 되는 RAG 기반 검색입니다.recent message history.
유사성 검색을 위해 메시지의 벡터 임베딩을 사용하고 벡터 저장소와 통합되며 검색된 메시지에 대해 구성 가능한 컨텍스트 창이 있습니다.
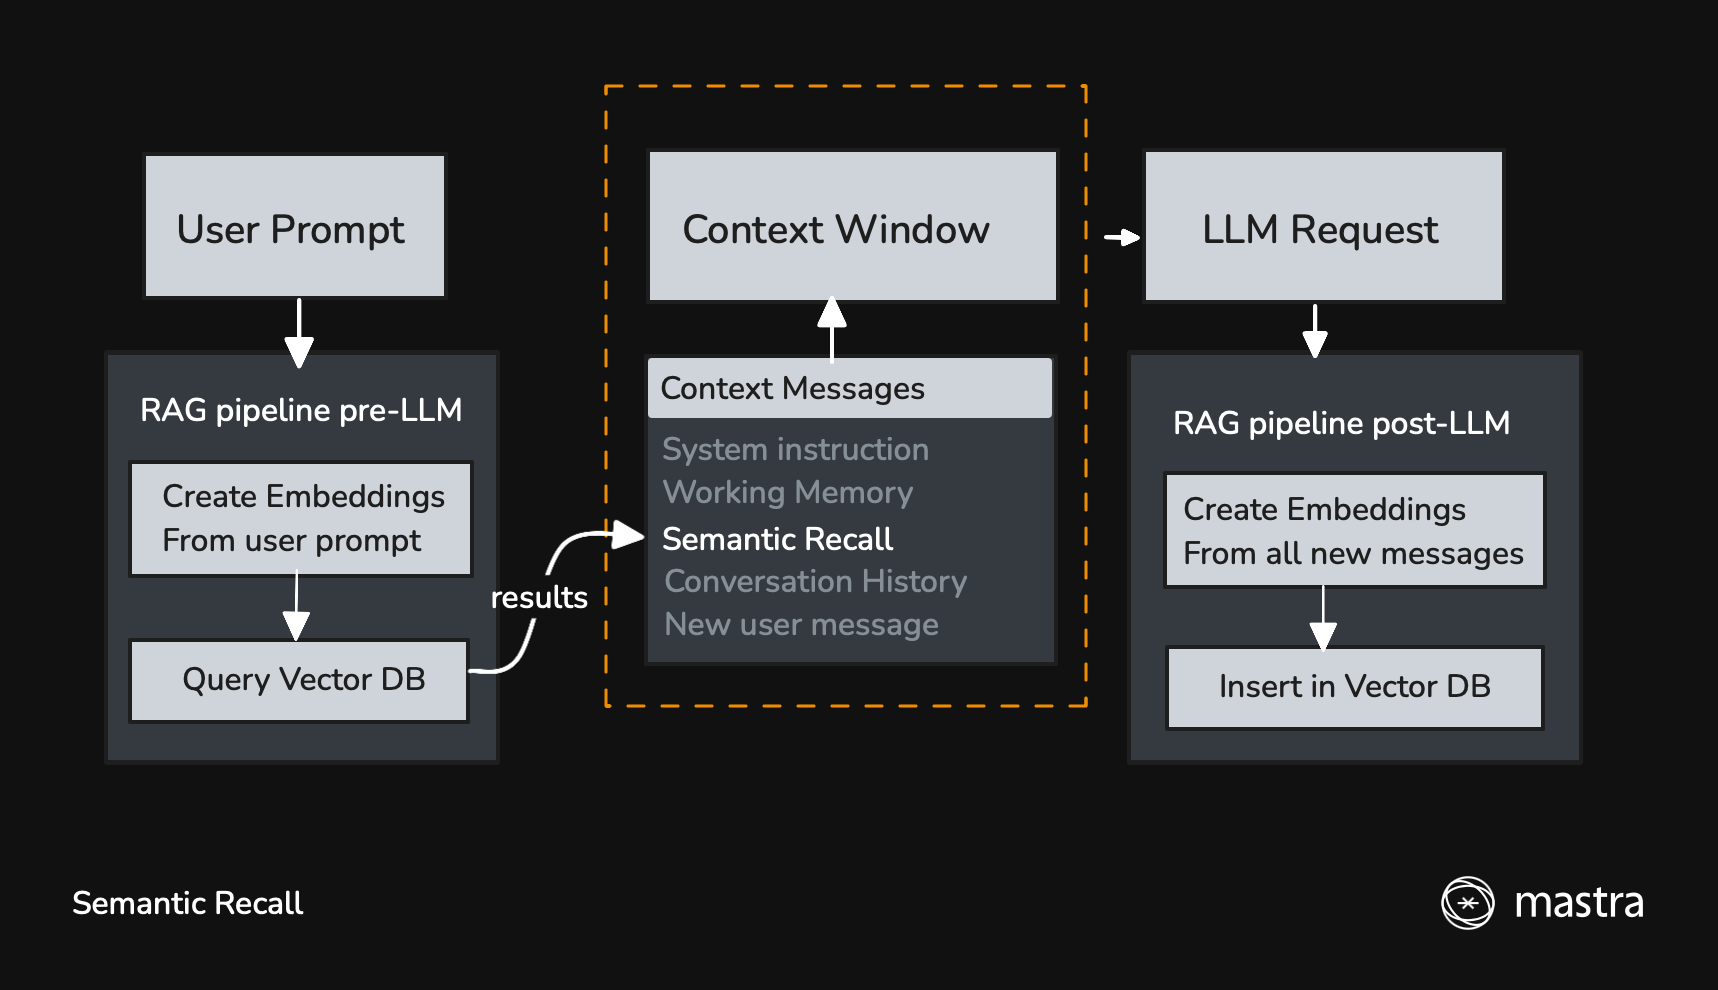
활성화되면 새 메시지를 사용하여 벡터 DB에서 의미상 유사한 메시지를 쿼리합니다.
LLM으로부터 응답을 받은 후 모든 새로운 메시지(사용자, 보조자 및 Tool 호출/결과)가 벡터 DB에 삽입되어 이후 상호 작용에서 호출됩니다.
빠른 시작빠른 시작에 대한 직접 링크
의미적 회상은 기본적으로 비활성화되어 있습니다. 활성화하려면 다음을 설정하세요.semanticRecall: true in options and provide a vector store and embedder:
- LibSQL
- MongoDB
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { MongoDBStore, MongoDBVector } from '@mastra/mongodb'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new MongoDBStore({
      id: 'agent-storage',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    vector: new MongoDBVector({
      id: 'agent-vector',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
사용하여recall() methodusing-the-recall-method에 대한 직접 링크
하는 동안listMessages 은 기본 페이지네이션을 사용하여 스레드 ID별로 메시지를 검색하며, recall() adds support for semantic search. 최신순이 아니라 의미를 기준으로 메시지를 찾아야 할 때는 recall() with a vectorSearchString:
const memory = await agent.getMemory()

// Basic recall - similar to listMessages
const { messages } = await memory!.recall({
  threadId: 'thread-123',
  perPage: 50,
})

// Semantic recall - find messages by meaning
const { messages: relevantMessages } = await memory!.recall({
  threadId: 'thread-123',
  vectorSearchString: 'What did we discuss about the project deadline?',
  threadConfig: {
    semanticRecall: true,
  },
})
스토리지 구성스토리지 구성에 대한 직접 링크
의미적 회상은storage and vector db to store messages and their embeddings.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'

const agent = new Agent({
  memory: new Memory({
    // this is the default storage db if omitted
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    // this is the default vector db if omitted
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    options: {
      semanticRecall: true,
    },
  }),
})
아래의 각 벡터 스토어 페이지에는 설치 지침, 구성 매개변수 및 사용 예가 포함되어 있습니다.
- 아스트라
- 크로마
- Cloudflare 벡터화
- 볼록한
- 카우치베이스
- 덕DB
- 엘라스틱서치
- 랜스DB
- libSQL
- 몽고DB
- 오픈서치
- 오라클DB
- 솔방울
- 포스트그레SQL
- Qdrant
- S3 벡터
- 터보퍼퍼
- 업스태시
구성 불러오기구성 불러오기에 대한 직접 링크
다음 옵션은 의미적 회상 동작을 제어합니다.
- 탑K: 검색할 유사한 메시지 수
- 메시지 범위: 각 일치 항목에 포함할 주변 메시지
- 범위: 리소스에 대해 현재 스레드를 검색할지 아니면 모든 스레드를 검색할지 여부
- 필터: 검색 결과를 제한하는 메타데이터 기준
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        topK: 3, // Retrieve 3 similar messages
        messageRange: 2, // Include 2 messages before and after each match
        scope: 'resource', // Search all threads for this resource
        filter: { projectId: { $eq: 'project-a' } },
      },
    },
  }),
})
scope: 'resource'LibSQL, OracleDB, PostgreSQL, MongoDB 및 Upstash 스토리지 어댑터에서 지원됩니다.
메타데이터 필터링메타데이터 필터링에 대한 직접 링크
그만큼filter 을 사용하세요. 옵션은 의미 기반 회상 결과를 메타데이터가 일치하는 스레드의 메시지로 제한합니다.
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        scope: 'resource',
        filter: {
          projectId: { $eq: 'project-a' },
          category: { $in: ['work', 'personal'] },
        },
      },
    },
  }),
})
필터는 메시지가 저장될 때 메시지 삽입에 저장된 메타데이터와 일치합니다. 나중에 스레드 메타데이터가 변경되면 기존 임베딩은 해당 메시지가 다시 저장되거나 인덱싱될 때까지 이전 메타데이터를 유지합니다.
지원되는 필터 연산자:
$and: 논리 AND$eq: 같음$gt:보다 큼$gte: 크거나 같음$in: 배열 내$lt: 미만$lte: 작거나 같음$ne: 같지 않음$nin: 배열에 없음$or: 논리적 OR
다음 예에서는 일반적인 사용 사례에 대한 메타데이터 필터를 보여줍니다.
// Filter by project
const options = {
  semanticRecall: { filter: { projectId: { $eq: 'my-project' } } },
}

// Filter by multiple categories
const options = {
  semanticRecall: { filter: { category: { $in: ['work', 'research'] } } },
}

// Filter by project and priority
const options = {
  semanticRecall: {
    filter: {
      $and: [{ projectId: { $eq: 'project-a' } }, { priority: { $gte: 3 } }],
    },
  },
}
임베더 구성임베더 구성에 대한 직접 링크
의미적 회상은 다음에 의존합니다.embedding model 을 사용하여 메시지를 임베딩으로 변환합니다. Mastra는 provider/model strings, or you can use any embedding model compatible with the AI SDK.
Model 라우터 사용(권장)Model 라우터 사용(권장)에 대한 직접 링크
가장 간단한 방법은provider/model string with autocomplete support:
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
지원되는 임베딩 Model:
- 오픈AI:
text-embedding-3-small,text-embedding-3-large,text-embedding-ada-002 - Google:
gemini-embedding-001 - 오픈라우터: 다양한 공급자의 임베딩 Model에 액세스
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel({
      providerId: 'openrouter',
      modelId: 'openai/text-embedding-3-small',
    }),
  }),
})
Model 라우터는 환경 변수(OPENAI_API_KEY, GOOGLE_API_KEY, OPENROUTER_API_KEY). Google models also fall back to GOOGLE_GENERATIVE_AI_API_KEY.
AI SDK 패키지 사용AI SDK 패키지 사용에 대한 직접 링크
AI SDK 임베딩 Model을 직접 사용할 수도 있습니다.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
  }),
})
FastEmbed 사용(로컬)FastEmbed 사용(로컬)에 대한 직접 링크
FastEmbed(로컬 임베딩 Model)를 사용하려면 다음을 설치하세요.@mastra/fastembed:
- npm
- pnpm
- Yarn
- Bun
npm install @mastra/fastembed@latest
pnpm add @mastra/fastembed@latest
yarn add @mastra/fastembed@latest
bun add @mastra/fastembed@latest
그런 다음 Memory에서 구성하십시오.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { fastembed } from '@mastra/fastembed'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: fastembed,
  }),
})
PostgreSQL 인덱스 최적화PostgreSQL 인덱스 최적화에 대한 직접 링크
PostgreSQL을 벡터 저장소로 사용하는 경우 벡터 인덱스를 구성하여 의미 재현 성능을 최적화할 수 있습니다. 이는 수천 개의 메시지가 포함된 대규모 배포에 특히 중요합니다.
PostgreSQL은 IVFFlat 및 HNSW 인덱스를 모두 지원합니다. 기본적으로 Mastra는 IVFFlat 인덱스를 생성하지만 HNSW 인덱스는 일반적으로 특히 내부 곱 거리를 사용하는 OpenAI 임베딩에서 더 나은 성능을 제공합니다.
import { Memory } from '@mastra/memory'
import { PgStore, PgVector } from '@mastra/pg'

const agent = new Agent({
  memory: new Memory({
    storage: new PgStore({
      id: 'agent-storage',
      connectionString: process.env.DATABASE_URL,
    }),
    vector: new PgVector({
      id: 'agent-vector',
      connectionString: process.env.DATABASE_URL,
    }),
    options: {
      semanticRecall: {
        topK: 5,
        messageRange: 2,
        indexConfig: {
          type: 'hnsw', // Use HNSW for better performance
          metric: 'dotproduct', // Best for OpenAI embeddings
          m: 16, // Number of bi-directional links (default: 16)
          efConstruction: 64, // Size of candidate list during construction (default: 64)
        },
      },
    },
  }),
})
인덱스 구성 옵션 및 성능 조정에 대한 자세한 내용은 다음을 참조하세요.PgVector configuration guide.
의미적 회상 비활성화의미적 회상 비활성화에 대한 직접 링크
의미적 회상은 기본적으로 비활성화되어 있습니다(semanticRecall: false을 사용하는 Model 라우터를 통해 임베딩 Model을 지원합니다. 각 호출에서는 새 메시지가 임베딩으로 변환되고 LLM에 전달되기 전에 벡터 데이터베이스 쿼리에 사용되므로 지연 시간이 늘어납니다.
다음과 같은 경우 의미적 회상을 비활성화 상태로 유지합니다.
- 메시지 기록은 현재 대화에 대한 충분한 맥락을 제공합니다.
- 임베딩 및 벡터 쿼리 대기 시간이 눈에 띄는 실시간 양방향 오디오와 같이 성능에 민감한 애플리케이션을 구축하고 있습니다.
회수된 메시지 보기회수된 메시지 보기에 대한 직접 링크
추적이 활성화되면 의미 체계 회상을 통해 검색된 모든 메시지는 최근 메시지 기록(구성된 경우)과 함께 Agent의 추적 출력에 표시됩니다.