관찰 기억
추가된 항목: @mastra/memory@1.1.0
관찰 기억(OM)은 긴 맥락의 Agent 기억을 위한 Mastra의 기억 시스템입니다. 백그라운드 Agent,Observer and a Reflector, Agent의 대화를 관찰하고 증가하는 원시 메시지 기록을 대체하는 밀집된 관찰 로그를 유지관리하세요.
빠른 시작빠른 시작에 대한 직접 링크
당신이 가지고 있는지 확인하십시오@mastra/memory installed in your project. Set observationalMemory: true Observational Memory를 활성화하려면 Memory 구성에 설정하세요.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
이제 Agent는 대화 전반에 걸쳐 지속되는 인간과 같은 장기 기억을 갖게 되었습니다. 환경observationalMemory: true uses google/gemini-2.5-flash 을 기본적으로 사용합니다. 다른 Model을 사용하려면 구성 객체에 전달하세요:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
보다configuration options for full API details.
클라이언트 애플리케이션과 함께 OM을 사용하는 경우only the new message 전체 대화 기록 대신 클라이언트에서 전달하세요.
관찰 기억은 여전히 저장된 대화 기록에 의존합니다. 전체 기록을 보내는 것은 중복되며 클라이언트 측 타임스탬프가 저장된 타임스탬프와 충돌할 때 메시지 순서 버그가 발생할 수 있습니다.
AI SDK 예시는 다음을 참조하세요.Using Mastra Memory.
OM은 현재 다음만 지원합니다.@mastra/pg, @mastra/libsql, @mastra/mysql, @mastra/mongodb, @mastra/convex, and @mastra/oracledb 스토리지 어댑터를 지원합니다.
Memory 관리에는 백그라운드 Agent를 사용합니다. Model이 설정되지 않은 경우 기본 Model은 google/gemini-2.5-flash.
시간적 간격 마커시간적 간격 마커에 대한 직접 링크
시간 간격 마커는 스레드의 이전 메시지 이후 충분한 시간이 경과한 경우 새 사용자 메시지 앞에 짧은 알림을 삽입합니다. 이는 Agent와 UI가 유용한 일시 중지 후 대화가 재개되었음을 확인하는 데 도움이 됩니다.
시간 간격 마커는 기본적으로 꺼져 있습니다. 다음을 사용하여 활성화하세요.temporalMarkers: true in the observationalMemory config:
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
Mastra는 간격이 10분 이상인 경우 시간 간격 마커를 삽입합니다. 마커는 Memory에 저장되고 일시적인 알림 이벤트로도 생성되므로 클라이언트는 이를 가벼운 타임라인 힌트로 렌더링할 수 있습니다.
또한 관찰자는 스레드를 처리할 때 이러한 마커를 볼 수 있으므로 기록하는 관찰은 발생한 시점에 대한 기억을 고정할 수 있습니다(예: "사용자가 2일 간격 후에 배포에 대해 질문했습니다.").
보다the API reference for the full configuration shape.
조기 활성화조기 활성화에 대한 직접 링크
OM은 토큰 임계값에 도달하기 전에 버퍼링된 관찰을 활성화할 수 있습니다. 이는 Prompt 캐시가 만료될 가능성이 있거나 Agent가 Model 공급자를 변경할 때 유용합니다.
최상위 초기 활성화 설정은 기본적으로 관찰에 적용됩니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
중첩 사용observation and reflection 설정을 사용해 단계별로 제어할 수 있습니다. Reflection 조기 활성화는 명시적으로 선택해야 하므로 최상위 설정은 관찰에만 영향을 줍니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
이 예에서는 관찰에 대해 최상위 유휴 설정이 비활성화되는 반면, 리플렉션은 유휴 및 공급자 변경 활성화를 선택합니다.
유휴 상태의 버퍼유휴 상태의 버퍼에 대한 직접 링크
세트observation.bufferOnIdle to true 을 사용하면 Agent 턴이 종료되어 Agent가 유휴 상태가 될 때 백그라운드 관찰 버퍼링을 실행할 수 있습니다. 다음 턴이나 messageTokens threshold.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle기본적으로 꺼져 있습니다. 와는 별개이다bufferTokens: bufferTokens controls step-time async buffering, while bufferOnIdle controls end-of-turn buffering for idle turns.
보다the API reference for the full configuration shape.
이익이익에 대한 직접 링크
- Prompt 캐싱: OM의 컨텍스트는 안정적이며 매 턴 런타임에 검색되지 않고 시간이 지남에 따라 관찰이 추가됩니다. 이렇게 하면 Prompt 접두어를 캐시할 수 있게 유지되어 비용이 절감됩니다.
- 압축: 원시 메시지 기록과 Tool 결과가 밀집된 관찰 로그로 압축됩니다. 컨텍스트가 작을수록 더 빠른 응답과 더 긴 일관성 있는 대화를 의미합니다.
- 제로 컨텍스트 부패: Agent는 시끄러운 Tool 호출과 관련 없는 토큰 대신 관련 정보를 확인하므로 Agent는 긴 세션 동안 작업을 계속할 수 있습니다.
작동 원리작동 원리에 대한 직접 링크
당신은 지금까지 나눈 모든 대화의 모든 단어를 기억하지 못합니다. 무의식적으로 무슨 일이 일어났는지 관찰하면 뇌는 반영하고, 재구성하고, 결합하고, 장기 기억으로 응축합니다. OM도 같은 방식으로 작동합니다.
Agent가 응답할 때마다 시스템 Prompt, 최근 메시지 기록 및 삽입된 컨텍스트가 포함된 컨텍스트 창이 표시됩니다. 컨텍스트 창은 유한합니다. 토큰 제한이 큰 Model이라도 창이 가득 차면 성능이 저하됩니다. 이로 인해 두 가지 문제가 발생합니다.
- 컨텍스트 부패: Agent가 전달하는 원시 메시지 기록이 많을수록 성능이 저하됩니다.
- 맥락 낭비: 대부분의 기록에는 Agent의 작업을 유지하는 데 더 이상 필요하지 않은 토큰이 포함되어 있습니다.
OM은 이전 컨텍스트를 조밀한 관찰로 압축하여 두 가지 문제를 모두 해결합니다.
관찰관찰에 대한 직접 링크
메시지 기록 토큰이 임계값(기본값: 30,000)을 초과하면 관찰자는 발생한 일에 대한 간결한 메모인 관찰을 생성합니다.
OM은 이 임계값 작업을 위해 빠른 로컬 토큰 추정을 사용합니다. 텍스트는 다음과 같이 추정됩니다.tokenx이며, 이미지 파트에는 Provider를 인식하는 휴리스틱을 사용하므로 멀티모달 대화에서도 적절한 시점에 관찰이 트리거됩니다. 업로드된 이미지가 전송 과정에서 이미지 파트가 아닌 파일로 정규화되는 경우 이미지와 유사한 file 파트에도 동일하게 적용됩니다. 예를 들어 OpenAI 이미지 세부 정보 설정은 OM이 관찰 시점을 결정하는 데 상당한 영향을 줄 수 있습니다.
관찰자는 검토 기록에서 첨부 파일을 볼 수도 있습니다. OM은 다음과 같은 읽을 수 있는 자리 표시자를 유지합니다.[Image #1: reference-board.png] or [File #1: floorplan.pdf] 을 가독성을 위해 대화 기록에 표시하고 실제 첨부 파일 파트는 텍스트와 함께 전달합니다. 이미지와 유사한 file 파트는 가능한 경우 Observer의 이미지 입력으로 변환되며, 이미지가 아닌 첨부 파일은 정규화된 토큰 계산과 함께 파일 파트로 전달됩니다. 이는 일반적인 스레드 관찰과 일괄 처리되는 리소스 범위 관찰 모두에 적용됩니다.
추출기추출기에 대한 직접 링크
OM이 관찰과 함께 특정 값을 유지하도록 하려면 추출기를 사용하십시오. 다음과 같은 내장 값current task, suggested response, and thread title 은 사용자 지정 값과 동일한 추출 파이프라인을 사용합니다.
다음 예에서는 관찰에서 컴팩트 사용자 프로필을 추출합니다.
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
추가schema 을 사용하면 추출기가 후속 구조화 출력 요청으로 실행됩니다. 스키마가 없는 추출기는 Observer 또는 Reflector 응답에서 직접 내보내는 인라인 문자열 추출기입니다.
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
기본적으로 OM은 나중에 실행될 때 마지막으로 추출된 값을 추출기에 표시합니다. 세트includePreviousExtraction: false 은 Observer가 이전 값을 확인하면 안 되는 경우에 사용합니다.
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
런타임 사용instructions or schema 은 추출기에 활성 Memory 인스턴스나 요청 컨텍스트 같은 런타임 컨텍스트가 필요할 때 함수로 지정할 수 있습니다:
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
스트림에서 추출된 값 읽기스트림에서 추출된 값 읽기에 대한 직접 링크
OM이 관찰 또는 반영을 완료하면 추출기 결과가 방출됩니다. 스트림에서 완료 데이터 부분을 모두 읽습니다.
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues각 추출기의 슬러그를 키로 사용합니다. 두 결과 필드 모두 선택 사항이며, 실패한 추출기는 성공한 추출기에서 값을 제거하지 않습니다.
data-om-observation-end동기 완료를 보고합니다.data-om-buffering-end 은 완료된 백그라운드 작업을 보고합니다. 추출기 메타데이터는 즉시 영구 저장되지만 버퍼링된 콘텐츠는 활성화될 때까지 비활성 상태로 유지됩니다. 완료된 작업이 관찰인지 Reflection인지 확인하려면 operationType 을 확인하세요.
참조data-om-observation-end and data-om-buffering-end reference tables for the complete payloads.
작업 기억 업데이트작업 기억 업데이트에 대한 직접 링크
사용observationalMemory.observation.manageWorkingMemory 을 사용하면 Observer가 working memory를 자동으로 관리합니다. 기본 Agent는 사용자 요청을 처리하는 동안 더 이상 working memory Tool을 호출할 필요가 없으므로, working memory 업데이트가 Agent가 이를 기억하고 실행하는지에 좌우되지 않습니다.
이는 또한 작업 Memory Prompt 캐시 친화적인 상태를 유지합니다. 작업 Memory는 일반적으로 시스템 Prompt에 있으므로 업데이트로 인해 Prompt 캐시가 무효화될 수 있습니다. OM 관리 작업 Memory 기본값workingMemory.useStateSignals to true을 사용하면 대신 working memory가 상태 신호로 이동합니다.
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
이 설정은 추가합니다WorkingMemoryExtractor, defaults workingMemory.agentManaged to false, and defaults workingMemory.useStateSignals to true. Set workingMemory.agentManaged: true 은 기본 Agent가 계속해서 working memory Tool과 지침 주입을 받아야 하는 경우에 사용합니다.
사용onExtracted 을 사용하면 사용자 지정 추출 값이 영구 저장되기 전에 이를 정규화하거나 이에 대응할 수 있습니다:
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
추출기 실패는 OM 마커에 보고되며 다른 성공적인 추출기 값을 차단하지 않습니다. 보다the API reference for the full Extractor shape.
Observer Model이 텍스트 전용이거나 해당 API가 다중 모드 입력을 거부하는 경우 다음을 설정하세요.observation.observeAttachments to false 을 사용하면 첨부 파일이 Observer에 도달하기 전에 제외할 수 있습니다. 읽기 쉬운 자리표시자([Image #1: ...], [File #1: ...])는 대화 기록에 유지되므로 Observer는 바이너리 페이로드를 받지 않고도 공유된 내용을 추론할 수 있습니다. 이미지 또는 파일 파트가 포함된 Tool 결과에도 동일한 필터가 적용됩니다:
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
mimeType glob의 허용 목록을 전달할 수도 있습니다(예:['image/*'])를 사용해 Observer가 처리할 수 있는 종류만 전달하세요. 또는 observeAttachments: 'auto' 을 설정해 Mastra가 Provider 기능 레지스트리를 기반으로 결정하도록 할 수 있습니다. Observer Model이 멀티모달 입력을 지원하면 첨부 파일을 전달하고, 그렇지 않으면 제외하며, true Model의 기능 데이터를 사용할 수 없는 경우에는 이를 대체 설정으로 사용합니다.
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
압축은 일반적으로 5x에서 40x 사이입니다. Observer는 또한 다음을 추적합니다.current task and suggested response so the agent picks up where it left off.
활성화하면observation.threadTitle을 사용하면 대화 주제가 의미 있게 바뀔 때 Observer가 짧은 스레드 제목도 제안할 수 있습니다. 스레드 제목 생성은 명시적으로 선택해야 하며 스레드 메타데이터를 업데이트하므로, Mastra Code 같은 앱은 스레드 목록과 상태 UI에 최신 제목을 표시할 수 있습니다.
예: Playwright MCP를 사용하는 Agent는 페이지 스냅샷당 50,000개 이상의 토큰을 볼 수 있습니다. OM을 사용하면 관찰자는 상호 작용을 관찰하고 페이지에 무엇이 있었고 어떤 조치가 취해졌는지에 대한 수백 개의 관찰 토큰을 생성합니다. Agent는 모든 원시 스냅샷을 가져오지 않고도 작업을 계속합니다.
반사반사에 대한 직접 링크
관찰이 임계값(기본값: 40,000개 토큰)을 초과하면 Reflector는 관찰을 압축하고 관련 항목을 결합하며 패턴을 반영합니다.
반사는 계속해서 증가하는 별도의 레이어로 누적되지 않습니다. 각 반사는 전체 관찰 로그를 다시 작성합니다. Reflector의 출력은 새로운 로그가 되고 그 뒤에 새로운 관찰이 추가됩니다. 다음에 로그가 임계값에 도달하면 Reflector는 이전 반사를 포함하여 모든 것을 다시 처리합니다. 최신 세부 정보를 유지하면서 오래된 정보를 보다 적극적으로 압축합니다. 대화가 얼마나 오래 진행되든 Memory는 반영 임계값 주위에 제한된 상태로 유지됩니다.
그 결과는 3계층 시스템입니다.
- 최근 메시지: 현재 작업에 대한 정확한 대화 기록
- 관찰: 관찰자가 본 것에 대한 기록
- 반사: 기억이 너무 길어지면 요약된 관찰
시간이 지남에 따라 상황이 어떻게 변하는가시간이 지남에 따라 상황이 어떻게 변하는가에 대한 직접 링크
기본 설정을 사용하면 컨텍스트 창이 무제한으로 커지지 않습니다. 관찰 및 축소 주기를 통해 진동합니다.
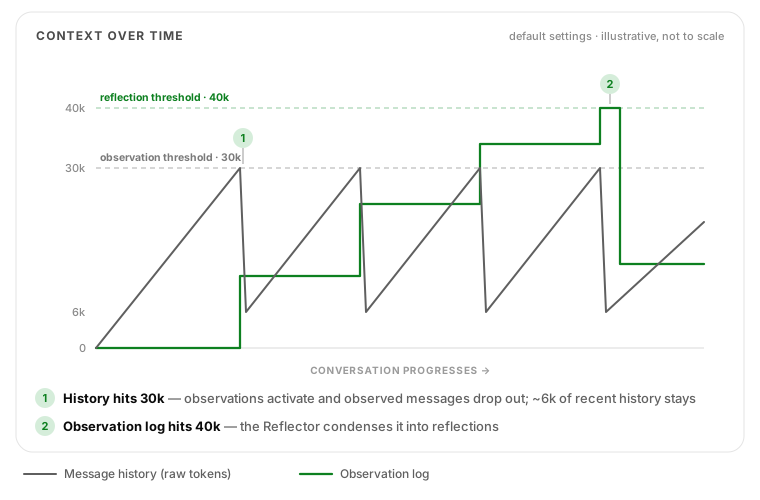
- 0 → 30,000개 토큰: 메시지 기록이 정상적으로 늘어납니다. 백그라운드에서 관찰자는 ~6,000개 토큰마다 관찰을 버퍼링합니다(
bufferTokens: 0.2). - 30,000명 도달: 버퍼링된 관측이 즉시 활성화됩니다. 관찰된 메시지는 컨텍스트 창에서 제거되고 최근 기록의 약 6,000개 토큰만 남습니다(
bufferActivation: 0.8은 임곗값의 20%를 유지합니다). 제거된 약 24,000개 토큰의 메시지는 일반적인 540배 압축을 통해 약 1,0005,000개 토큰의 관찰 내용이 됩니다. - 반복하다: 기록은 ~6k에서 다시 30k로 증가했다가 다시 축소됩니다. 각 주기는 관찰 로그에 추가되며 원시 기록보다 훨씬 느리게 증가합니다.
- 관측치가 40,000에 도달함: 반사경은 현재 관찰과 이전 반사로부터 더 작은 로그를 생성합니다.
일반적인 버퍼링 주기에서 원시 기록은 대략 6,000개에서 30,000개 토큰 사이에서 진동합니다. 관찰 로그는 약 40,000개의 토큰으로 유지되지만 대화가 지속되는 시간은 오래 걸립니다. 이는 하드 캡이 아닌 활성화 임계값입니다. 백그라운드 버퍼링이 속도를 유지하지 못하는 경우 기록은 다음이 될 때까지 임계값을 넘어 증가할 수 있습니다.blockAfter (default 1.2)는 안전 상한으로 약 36,000개 토큰(Reflection의 경우 약 48,000개)에서 동기식 관찰을 강제로 실행합니다.
와 함께shareTokenBudget 을 활성화하면 두 예산이 합쳐집니다. 관찰 로그가 작을 때는 관찰이 트리거되기 전까지 메시지 기록이 사용되지 않는 관찰 공간으로 확장될 수 있습니다(기본값 사용 시 최대 약 70,000개 토큰). 이후 관찰 내용이 누적되면 다시 축소됩니다.
검색 모드검색 모드에 대한 직접 링크
일반 OM은 메시지를 관찰로 압축하므로 작업을 계속하는 데 적합하지만 원래 문구는 사라졌습니다. 검색 모드는 각 관찰 그룹을 생성한 원시 메시지에 연결된 상태로 유지하여 이 문제를 해결합니다. Agent가 요약에서 압축한 정확한 문구, Tool 출력 또는 연대기가 필요한 경우recall tool to page through the source messages.
탐색만탐색만에 대한 직접 링크
세트retrieval: true 을 사용하면 원시 메시지를 탐색하는 recall Tool을 활성화할 수 있습니다. 벡터 스토어는 필요하지 않습니다. 기본적으로 recall Tool은 현재 리소스의 모든 스레드를 탐색할 수 있습니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
의미 검색의미 검색에 대한 직접 링크
세트retrieval: { vector: true } 을 사용하면 시맨틱 검색도 활성화할 수 있습니다. 이 기능은 Memory 인스턴스에 이미 구성된 벡터 스토어와 임베더를 재사용합니다:
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
벡터 검색이 구성되면 버퍼 시간과 동기 관찰(fire-and-forget, 비차단) 중에 새 관찰 그룹이 자동으로 인덱싱됩니다. 의미론적 검색은 원시 소스 메시지 ID 범위와 일치하는 관찰 그룹을 반환하므로 회상 Tool은 요약된 Memory를 해당 Memory의 출처와 함께 표시할 수 있습니다.
현재 스레드로 제한현재 스레드로 제한에 대한 직접 링크
기본적으로 회수 Tool 범위는 다음과 같습니다.'resource'을 사용하면 Agent가 스레드 목록을 조회하고 다른 스레드를 탐색할 수 있으며, 모든 대화를 검색할 수도 있습니다. Agent를 현재 스레드로만 제한하려면 scope: 'thread' 을 설정하세요:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
맞춤형 리콜 지침맞춤형 리콜 지침에 대한 직접 링크
Mastra는 Agent에게 스레드를 검색하고, 나열하고, 특정 스레드를 읽는 시기를 알려주는 범위 인식 지침을 주입합니다. 사용instructions 을 사용하면 기본 제공 지침 뒤에 애플리케이션별 지침을 추가할 수 있습니다. 기본 제공 지침은 대체되지 않습니다:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
이렇게 하면 Agent의 전체 지침 대신 리콜 관련 지침이 리콜 Tool에 연결되어 관련되지 않은 작업에 영향을 미치지 않습니다.
검색을 통해 가능한 것검색을 통해 가능한 것에 대한 직접 링크
검색 모드가 활성화된 경우 OM은 다음을 수행합니다.
- 상점
range(e.g.startId:endId)를 각 관찰 그룹에 추가하여 해당 관찰의 기반이 된 메시지를 가리킵니다 - Agent가 어떤 관찰이 어떤 메시지에 매핑되는지 알 수 있도록 Agent의 컨텍스트에 범위 메타데이터가 표시되도록 유지합니다.
- 등록하다
recalltool the agent can call to:- 관찰 그룹 범위 뒤의 원시 메시지 페이지를 살펴보세요.
- 의미적 유사성으로 검색(
mode: "search"with aquerystring); requiresvector: true - 모든 스레드 나열(
mode: "threads"), browse other threads (threadId), and search across all threads (defaultscope: 'resource') - 언제
scope: 'thread': 탐색과 검색을 현재 스레드로만 제한합니다
참조recall tool reference 에서 전체 API를 확인하세요(세부 정보 수준, 파트 인덱싱, 페이지네이션, 스레드 간 탐색 및 토큰 제한).
사진관사진관에 대한 직접 링크
실제로 어떻게 작동하는지 보려면 다음을 열어보세요.Studio 을 실행하고 OM이 활성화된 Agent로 이동하세요. Memory tab displays:
-
토큰 진행 표시줄: 메시지 및 관찰에 대한 현재 토큰 수로, 각각이 임계값에 얼마나 가까운지 보여줍니다. 정보 아이콘 위로 마우스를 가져가면 관찰자와 반사경의 Model과 임계값을 볼 수 있습니다.
-
활성 관찰: 현재 관측 로그가 인라인으로 표시됩니다. 이전 관찰 또는 반영 기록이 있는 경우 "이전 관찰"을 확장하여 찾아보세요.
-
백그라운드 처리: 대화 중 버퍼링된 관찰 청크와 반사 상태는 Agent가 백그라운드에서 처리하면서 나타납니다.
Agent가 관찰하거나 반영하는 동안 진행률 표시줄이 실시간으로 업데이트되어 경과 시간과 상태 배지가 표시됩니다.
ModelModel에 대한 직접 링크
Observer와 Reflector는 백그라운드에서 실행됩니다. Mastra와 함께 작동하는 모든 Modelmodel routing (provider/model)를 사용할 수 있습니다. Model이 설정되지 않은 경우 기본 Model은 google/gemini-2.5-flash.
Mastra는 큰 컨텍스트 창(128K+ 토큰)이 있고 작업 속도를 늦추지 않고 백그라운드에서 실행할 수 있을 만큼 빠른 Model을 사용할 것을 권장합니다.
어떤 Model을 사용해야 할지 확실하지 않은 경우 기본값으로 시작하세요.google/gemini-2.5-flash. We've also successfully tested openai/gpt-5-mini, anthropic/claude-haiku-4-5, deepseek/deepseek-reasoner, deepseek/deepseek-v4-pro, deepseek/deepseek-v4-flash, xai/grok-4-1-fast, qwen3, and glm-4.7.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
보다model configuration for using different models per agent.
google/gemini-2.5-flash긴 출력의 세부 사항을 유지하는 데 유난히 좋습니다. 결과적으로 반사경은 구성된 수준 이상으로 유지되는 반사를 생성할 수 있습니다.reflection.observationTokens 임곗값을 최대 압축 재시도 후에도 충족하지 못할 수 있습니다. 이 경우 Reflector는 무한히 반복되지 않고 루프가 종료되도록 재시도 중 생성된, 의미를 잃지 않은 가장 작은 후보를 반환합니다.
반사경에 대해 보다 공격적인 압축을 원할 경우 다음과 같이 보다 쉽게 압축되는 Model로 교체하십시오.xai/grok-4-1-fast, deepseek/deepseek-v4-pro, or deepseek/deepseek-v4-flash. You can keep google/gemini-2.5-flash 을 Observer에 사용하고 Reflector에는 다른 Model을 사용할 수 있습니다. 자세한 내용은 different models per agent.
토큰 계층 Model 선택토큰 계층 Model 선택에 대한 직접 링크
추가된 항목: @mastra/memory@1.10.0
당신은 사용할 수 있습니다ModelByInputTokens 을 사용하면 입력 토큰 수에 따라 서로 다른 Observer 또는 Reflector Model을 지정할 수 있습니다. OM은 런타임에 구성된 upTo thresholds.
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
그만큼upTo 키를 포괄적인 상한으로 사용해 일치하는 Model 계층을 선택합니다. OM은 Observer 또는 Reflector 호출의 실제 입력 토큰 수를 계산하여 일치하는 계층을 직접 결정하고, 해당 구체적인 Model을 실행에 사용합니다.
입력이 구성된 최대 임계값을 초과하면 오류가 발생합니다. 임계값이 가능한 입력 크기의 전체 범위를 포괄하는지 확인하거나 가장 높은 계층에서 충분히 큰 컨텍스트 창이 있는 Model을 사용하세요.
범위범위에 대한 직접 링크
스레드 범위(기본값)스레드 범위(기본값)에 대한 직접 링크
각 스레드에는 자체 관찰이 있습니다. 이 범위는 잘 테스트되었으며 특히 장기 Agent 사용 사례의 경우 범용 Memory 시스템으로 잘 작동합니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
스레드 범위에는 유효한 항목이 필요합니다.threadId to be provided when calling the agent. If threadId 이 없으면 Observational Memory에서 오류가 발생합니다. 이를 통해 여러 스레드가 하나의 관찰 레코드를 자신도 모르게 공유하여 데이터베이스 교착 상태가 발생하는 일을 방지합니다.
리소스 범위(실험적)리소스 범위(실험적)에 대한 직접 링크
관찰은 리소스(일반적으로 사용자)에 대한 모든 스레드에서 공유됩니다. 교차 대화 Memory를 활성화합니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'resource',
    },
  },
})
리소스 범위는 작동하지만 진행 중인 여러 동시 스레드에서 작업 준수/연속성을 입증할 때까지 현재는 실험적인 것으로 표시됩니다. 오늘부터 다른 스레드가 이미 시작했지만 완료하지 않은 작업을 한 스레드가 계속하지 못하도록 시스템 Prompt를 조정해야 할 수도 있습니다.
이는 리소스 범위에서 각 스레드가 다음에 대한 관점이기 때문입니다.all threads for the resource.
귀하의 사용 사례에서는 이것이 문제가 되지 않을 수 있으므로 마일리지가 다를 수 있습니다.
리소스 범위 내에서 관찰되지 않은 메시지all 스레드는 함께 처리됩니다. 기존 스레드가 많은 사용자의 경우 처리 속도가 느릴 수 있습니다. 기존 앱에는 스레드 범위를 사용하세요.
토큰 예산토큰 예산에 대한 직접 링크
OM은 토큰 임계값을 사용하여 관찰 및 반영 시기를 결정합니다. 보다token budget configuration for details.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
토큰 계산 캐시토큰 계산 캐시에 대한 직접 링크
OM은 임계값 확인 및 버퍼링 결정 중에 반복 계산 작업을 줄이기 위해 메시지 메타데이터에 토큰 추정치를 캐시합니다.
- 부품별 견적은 다음 위치에 저장됩니다.
part.providerMetadata.mastra되고 캐시 버전과 토크나이저 소스가 일치하면 이후 처리에서 재사용됩니다. - 문자열 전용 메시지 콘텐츠(부분 없음)의 경우 OM은 메시지 수준 메타데이터 대체 캐시를 사용합니다.
- 메시지 및 대화 오버헤드는 여전히 모든 패스에서 다시 계산됩니다. 캐시는 페이로드 추정치만 저장하므로 계산 의미는 동일하게 유지됩니다.
data-*그리고reasoningparts are still skipped and aren't cached.
파일 부분에 대한 호출자 제공 토큰 추정치파일 부분에 대한 호출자 제공 토큰 추정치에 대한 직접 링크
토큰 견적을 직접 첨부할 수 있습니다.image or file part using providerMetadata.mastra.tokenEstimate. Token Counter는 이 값을 그대로 적용하고 자체 추정기를 건너뜁니다:
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
그만큼tokenEstimate 객체는 Token Counter가 캐시된 추정치에 내부적으로 사용하는 것과 동일한 구조를 따릅니다:
v: 캐시 스키마 버전. 다음으로 설정0. 호출자가 제공한 항목에는 프레임워크의 버전 검사가 적용되지 않으므로 이 값은 읽히지 않습니다.source: 캐시 계보 마커. 반드시'client'. 이 값은 해당 항목이 신뢰할 수 있는 값이며 재계산하거나 덮어쓰는 대신 그대로 적용해야 한다고 Token Counter에 알립니다.key: 콘텐츠 지문 슬롯. 다음으로 설정'client'. 프레임워크 항목은 여기에서 콘텐츠 해시를 사용하므로 페이로드가 변경되면 무효화됩니다.'client'sentinel keeps caller estimates stable across writes.tokens: 사용할 토큰 수입니다. 음수가 아닌 유한한 숫자여야 합니다.
추가 참고 사항:
- 견적은 다음에서만 인정됩니다.
imageandfileparts.textandtool-invocation파트는tokenEstimate.
비동기 버퍼링비동기 버퍼링에 대한 직접 링크
비동기 버퍼링이 없으면 관찰자는 메시지 임계값에 도달할 때 동기적으로 실행되고 Agent는 관찰자 LLM 호출이 완료되는 동안 대화 중간을 일시 중지합니다. 비동기 버퍼링(기본적으로 활성화됨)을 사용하면 대화가 증가함에 따라 관찰이 백그라운드에서 미리 계산됩니다. 임계값에 도달하면 버퍼링된 관찰이 일시 중지 없이 즉시 활성화됩니다.
작동 원리작동 원리에 대한 직접 링크
Agent가 대화하면 메시지 토큰이 누적됩니다. 일정한 간격으로 (bufferTokens)에 도달하면 백그라운드 Observer 호출이 Agent를 차단하지 않고 실행됩니다. 각 호출은 버퍼에 저장되는 관찰 내용의 "청크"를 생성합니다.
메시지 토큰이messageTokens 임곗값에 도달하면 버퍼링된 청크가 활성화됩니다. 해당 관찰 내용은 활성 관찰 로그로 이동하고, 관련 원시 메시지는 컨텍스트 창에서 제거됩니다. Agent는 중단되지 않습니다.
버퍼링된 관찰에는 연속 힌트, 제안된 다음 응답 및 현재 작업도 포함되므로 메인 Agent는 활성화 후 컨텍스트 창을 축소한 후에도 대화 연속성을 유지합니다.
Agent가 관찰자가 처리할 수 있는 것보다 더 빠르게 메시지를 생성하는 경우blockAfter 안전 임곗값은 최후의 수단으로 동기식 관찰을 강제로 실행합니다. 버퍼 활성화 시에도 최소 잔여 컨텍스트(약 1,000개 토큰과 구성된 유지 하한 중 더 작은 값)가 보존됩니다.
반사도 비슷하게 작동합니다. 관찰이 반사 임계값의 일부에 도달하면 반사기가 백그라운드에서 실행됩니다.
설정설정에 대한 직접 링크
| 설정 | 기본값 | 제어 대상 |
|---|---|---|
observation.bufferTokens | 0.2 | How often to buffer. 0.2 means every 20% of messageTokens. 기본 임곗값인 30,000개 토큰을 사용하면 약 6,000개 토큰마다 실행됩니다. 절대 토큰 수로 지정할 수도 있습니다(예: 5000). |
observation.bufferActivation | 0.8 | 활성화 시 메시지 창을 얼마나 적극적으로 비울지 지정합니다. 0.8 은 메시지를 충분히 제거하여 messageTokens remaining. Lower values keep more message history. |
observation.blockAfter | 1.2 | 버퍼링이 처리 속도를 따라가지 못할 경우를 위한 안전망입니다. 1 이상 100 미만의 값은 messageTokens: at 1.2에 곱해지며, 동기식 관찰은 36k 토큰(1.2 × 30k)에서 강제로 실행됩니다. 100 이상의 값은 절대 토큰 수입니다(예: 50_000). |
activateAfterIdle | 없음 | observation.messageTokens 에 도달하기 전이라도 일정 시간 동안 활동이 없으면 버퍼링된 관찰이 활성화되도록 강제합니다. 300_000, duration strings like "5m" or "1hr", or "auto" for a provider-aware prompt cache TTL. |
activateOnProviderChange | false 와 같은 숫자 밀리초 값을 사용할 수 있습니다. | 다음 단계에서 최신 어시스턴트 단계를 생성한 것과 다른 provider/model 을 사용할 때 버퍼링된 관찰이 활성화되도록 강제합니다. Provider나 Model을 전환하면 Prompt 캐시 재사용이 무효화되는 경우에 사용하세요. |
reflection.bufferActivation | 0.5 | When to start background reflection. 0.5 은 관찰이 observationTokens threshold. |
reflection.activateAfterIdle 의 50%에 도달하면 리플렉션이 시작된다는 의미입니다. | 없음 | 버퍼링된 리플렉션이 유휴 상태 활성화의 적용을 받도록 설정합니다. 리플렉션은 최상위 activateAfterIdle. |
reflection.activateOnProviderChange | false 을 상속하지 않습니다. | 버퍼링된 리플렉션이 Provider 변경 활성화의 적용을 받도록 설정합니다. 리플렉션은 최상위 activateOnProviderChange. |
reflection.blockAfter | 1.2 을 상속하지 않습니다. | 리플렉션의 안전 임곗값이며 관찰과 동일한 로직을 사용합니다. |
Prompt 캐싱에 의존하는 경우 다음을 설정하세요.activateAfterIdle to "auto" 또는 특정 캐시 TTL로 설정하세요. 그러면 캐시가 만료될 만큼 스레드가 오랫동안 유휴 상태였을 때 다음 요청이 먼저 버퍼링된 관찰을 활성화하고 더 작게 압축된 컨텍스트 창을 전송할 수 있습니다.
와 함께"auto"인 경우 Mastra는 활성 Model Provider를 기준으로 유휴 상태 활성화 TTL을 선택합니다.
| 공급자 | 자동 TTL |
|---|---|
| Anthropic, OpenRouter, 알 수 없는 공급자, xAI | 5분 |
| 딥시크 | 1시간 |
| 구글 제미니 | 24시간 |
| 그로크 | 2시간 |
OpenAI를 활용한providerOptions.openai.promptCacheRetention: "24h" | 1 hour |
OpenAI with providerOptions.openai.promptCacheRetention: "in_memory" | 5 minutes |
OpenAI gpt-4*, gpt-5, gpt-5-*, and gpt-5.1 through gpt-5.4 (including - suffixed variants) | 5 minutes |
| Other OpenAI models | 1 hour |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
와 함께"auto"인 경우 활성 Provider의 Prompt 캐시 동작을 기준으로 버퍼링된 관찰을 활성화하므로, 캐시되지 않은 다음 Prompt에서는 더 큰 원시 메시지 창 대신 압축된 관찰을 사용합니다. 고정된 5분 TTL을 사용하려면 "5m" or 300_000.
스레드 중간에 Model이나 공급자를 변경하면 Prompt 캐시가 무효화됩니다. Agent가 스레드 중간에 공급자나 Model 간에 전환할 수 있는 경우activateOnProviderChange: true 을 사용하세요. 새 Provider가 실행되기 전에 버퍼링된 관찰을 강제로 활성화합니다. 이렇게 하면 이전 Prompt 캐시를 재사용할 수 없는 Provider에 큰 원시 창을 전송하지 않아도 됩니다.
비활성화 중비활성화 중에 대한 직접 링크
비동기 버퍼링을 비활성화하고 대신 동기 관찰/반사를 사용하려면:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
환경bufferTokens: false 은 관찰과 리플렉션의 비동기 버퍼링을 모두 비활성화합니다. async buffering configuration for the full API.
비동기 버퍼링은 지원되지 않습니다.scope: 'resource'. It's automatically disabled in resource scope.
관찰자 컨텍스트 최적화관찰자 컨텍스트 최적화에 대한 직접 링크
기본적으로 관찰자는 새 메시지를 처리할 때 전체 관찰 기록을 컨텍스트로 수신합니다. 관찰자는 또한 사전에current-task and suggested-response 를 참조하세요. 메타데이터가 제공되는 경우 이를 사용하므로 관찰 컨텍스트가 잘리더라도 맥락을 유지할 수 있습니다. 관찰이 커지는 장기 대화에서는 컨텍스트 최적화를 사용하도록 설정해 Observer 입력 비용을 줄일 수 있습니다.
세트observation.previousObserverTokens 을 사용하여 Observer로 전송되는 이전 관찰의 토큰 수를 제한하세요. 관찰은 끝부분을 기준으로 잘려 가장 최근 항목이 유지됩니다. 버퍼링된 리플렉션이 대기 중이면 이미 리플렉션된 줄은 자르기를 적용하기 전에 자동으로 리플렉션 요약으로 대체됩니다.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: 2000→ 기본값. 최근 관찰의 ~2,000개 토큰을 보관합니다.previousObserverTokens: 0→ 이전 관찰을 완전히 생략합니다.previousObserverTokens: false→ 잘림을 비활성화하고 이전 관측값 전체를 유지합니다.
기존 스레드 마이그레이션기존 스레드 마이그레이션에 대한 직접 링크
수동 마이그레이션이 필요하지 않습니다. OM은 기존 메시지를 읽고 임계값이 초과되면 이를 천천히 관찰합니다.
- 스레드 범위: 스레드가 처음으로 초과하는 경우
observation.messageTokens, the Observer processes the backlog. - 자원 범위: 리소스의 모든 스레드에서 관찰되지 않은 모든 메시지가 함께 처리됩니다. 기존 스레드가 많은 사용자의 경우 상당한 시간이 걸릴 수 있습니다.
OM과 다른 Memory 기능 비교OM과 다른 Memory 기능 비교에 대한 직접 링크
- 메시지 기록: 현재 대화의 충실도 높은 녹음
- 작업기억: 사용자 기본 설정, 이름, 목표를 위한 소규모 구조화된 상태(JSON 또는 마크다운)
- 의미적 회상: 관련 과거 메시지의 RAG 기반 검색
- 다중 사용자 스레드: 여러 사람이 단일 스레드를 공유할 때 OM이 사실을 개별 사용자에게 귀속시키는 방법
작업 Memory를 사용하여 대화 요약이나 시간이 지남에 따라 증가하는 진행 상태를 저장하는 경우 OM이 더 적합합니다. 작업 Memory는 작고 구조화된 데이터를 위한 것입니다. OM은 장기 실행 이벤트 로그용입니다. OM은 또한 메시지 기록을 자동으로 관리합니다.messageTokens 설정은 관찰이 실행되기 전에 원시 기록을 얼마나 유지할지 제어합니다.
실질적으로 OM은 작업 Memory와 메시지 기록을 모두 대체하며 Semantic Recall보다 정확성이 높고 비용이 저렴합니다.
관련된관련된에 대한 직접 링크
- 관찰 Memory 참조
- Memory 개요
- 메시지 기록
- Memory 프로세서
- 마스트라 코드: 관찰기억을 이용한 코딩 Agent
- 📹 Mastra processors and Observational Memory workshop