Semantic recall
友人に先週末何をしていたか尋ねると、友人は記憶から「先週末」に関連する出来事を探し、何をしたか答えるでしょう。Mastra の semantic recall も、これとよく似た仕組みです。
Mastra semantic recall では、Agent が過去の会話から関連メッセージを取得する仕組みを動画で確認できます。
Semantic recall の仕組みSemantic recall の仕組みへの直接リンク
Semantic recall は RAG ベースの検索機能です。メッセージが直近のメッセージ履歴に含まれなくなった長い対話でも、Agent がコンテキストを維持できるようにします。
メッセージのベクトル埋め込みを用いて類似検索を行い、ベクトルストアと連携します。また、取得したメッセージの前後に含めるコンテキスト範囲を設定できます。
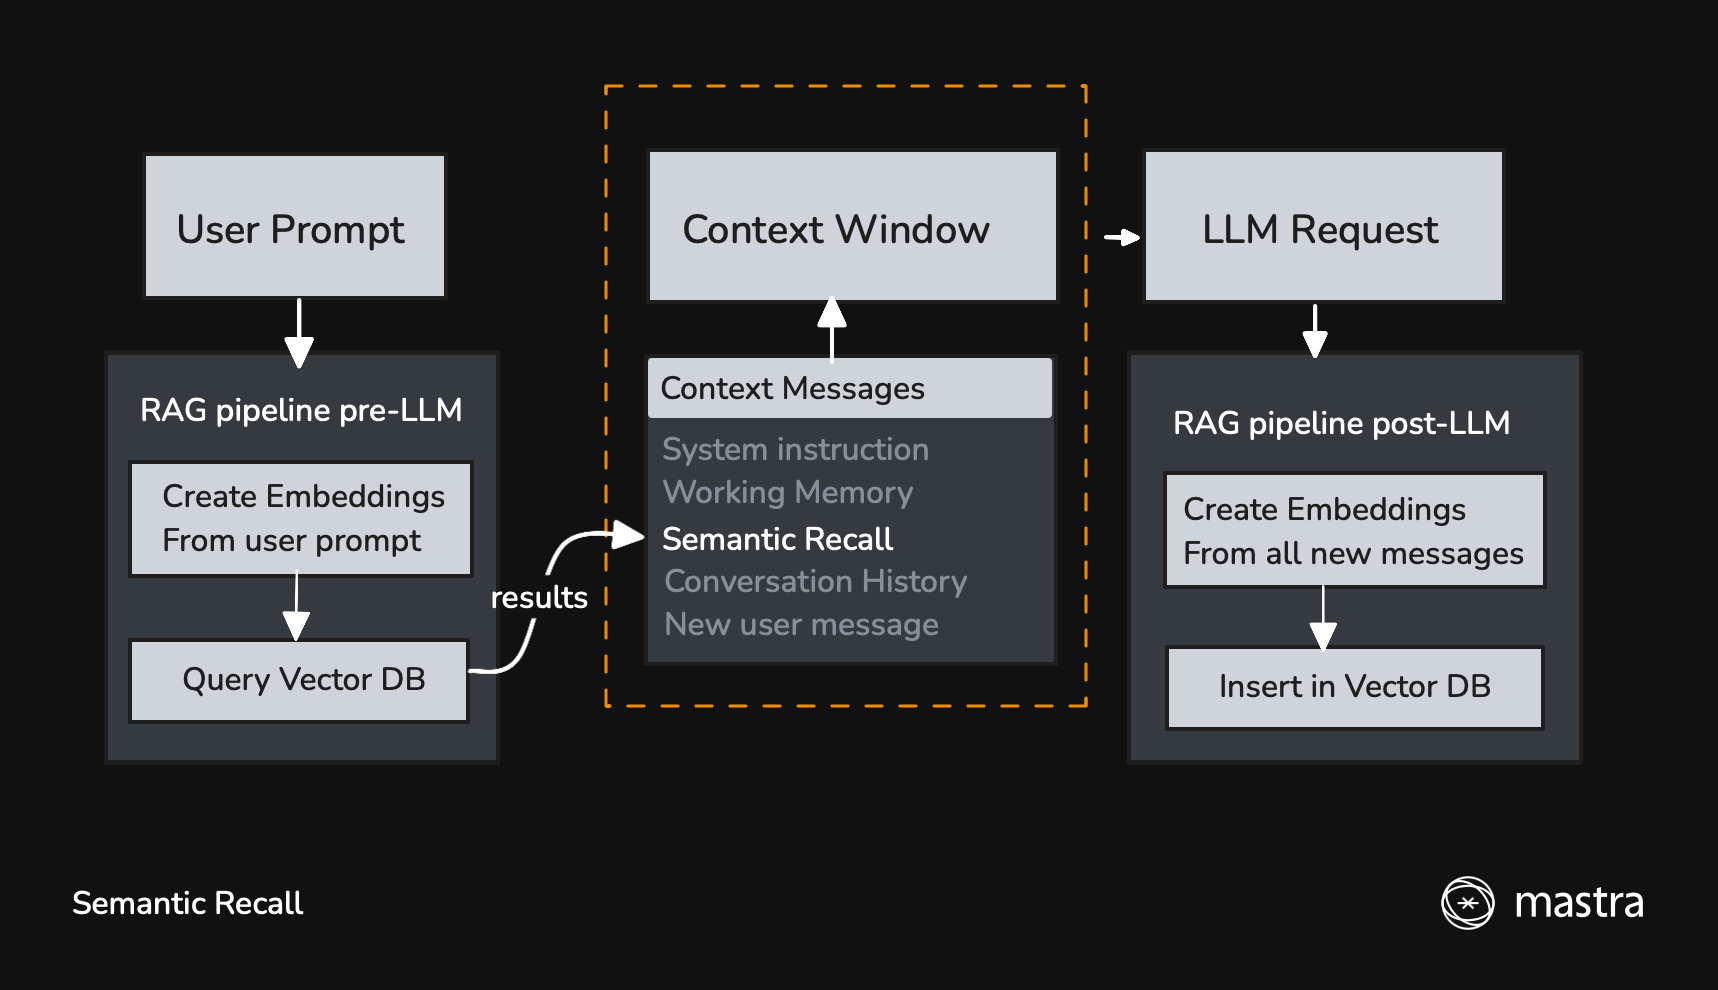
有効にすると、新しいメッセージをクエリとしてベクトル DB を検索し、意味的に類似するメッセージを取得します。
LLM から応答を取得した後、すべての新しいメッセージ(ユーザー、アシスタント、Tool の呼び出しと結果)がベクトル DB に追加され、以後の対話で呼び出せるようになります。
クイックスタートクイックスタートへの直接リンク
Semantic recall はデフォルトで無効です。有効にするには、options に semanticRecall: true を設定し、vector ストアと embedder を指定します。
- LibSQL
- MongoDB
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { MongoDBStore, MongoDBVector } from '@mastra/mongodb'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new MongoDBStore({
      id: 'agent-storage',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    vector: new MongoDBVector({
      id: 'agent-vector',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
recall() メソッドの使用using-the-recall-methodへの直接リンク
listMessages は基本的なページネーションを使ってスレッド ID ごとにメッセージを取得しますが、recall() はセマンティック検索にも対応します。新しさではなく意味に基づいてメッセージを探す場合は、vectorSearchString を指定して recall() を使用します。
const memory = await agent.getMemory()

// Basic recall - similar to listMessages
const { messages } = await memory!.recall({
  threadId: 'thread-123',
  perPage: 50,
})

// Semantic recall - find messages by meaning
const { messages: relevantMessages } = await memory!.recall({
  threadId: 'thread-123',
  vectorSearchString: 'What did we discuss about the project deadline?',
  threadConfig: {
    semanticRecall: true,
  },
})
ストレージの設定ストレージの設定への直接リンク
Semantic recall は、メッセージとその埋め込みを保存するストレージとベクトル DBを使用します。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'

const agent = new Agent({
  memory: new Memory({
    // this is the default storage db if omitted
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    // this is the default vector db if omitted
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    options: {
      semanticRecall: true,
    },
  }),
})
以下の各ベクトルストアのページでは、インストール手順、設定パラメーター、使用例を確認できます。
- Astra
- Chroma
- Cloudflare Vectorize
- Convex
- Couchbase
- DuckDB
- Elasticsearch
- LanceDB
- libSQL
- MongoDB
- OpenSearch
- OracleDB
- Pinecone
- PostgreSQL
- Qdrant
- S3 Vectors
- Turbopuffer
- Upstash
Recall の設定Recall の設定への直接リンク
以下のオプションで semantic recall の動作を制御します。
- topK: 取得する類似メッセージの数
- messageRange: 各一致メッセージとともに含める前後のメッセージ
- scope: 現在のスレッドを検索するか、リソースに属するすべてのスレッドを検索するか
- filter: 検索結果を制限するメタデータ条件
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        topK: 3, // Retrieve 3 similar messages
        messageRange: 2, // Include 2 messages before and after each match
        scope: 'resource', // Search all threads for this resource
        filter: { projectId: { $eq: 'project-a' } },
      },
    },
  }),
})
scope: 'resource' は LibSQL、OracleDB、PostgreSQL、MongoDB、Upstash のストレージアダプターでサポートされています。
メタデータによる絞り込みメタデータによる絞り込みへの直接リンク
filter オプションは、semantic recall の結果を、スレッドメタデータが一致するメッセージに限定します。
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        scope: 'resource',
        filter: {
          projectId: { $eq: 'project-a' },
          category: { $in: ['work', 'personal'] },
        },
      },
    },
  }),
})
フィルターは、メッセージの保存時に埋め込みへ格納されたメタデータと照合されます。後からスレッドメタデータが変更されても、既存の埋め込みは、そのメッセージが再度保存またはインデックス化されるまで以前のメタデータを保持します。
サポートされるフィルター演算子は次のとおりです。
$and: 論理積(AND)$eq: 等しい$gt: より大きい$gte: 以上$in: 配列に含まれる$lt: より小さい$lte: 以下$ne: 等しくない$nin: 配列に含まれない$or: 論理和(OR)
次の例は、一般的なユースケースにおけるメタデータフィルターを示しています。
// Filter by project
const options = {
  semanticRecall: { filter: { projectId: { $eq: 'my-project' } } },
}

// Filter by multiple categories
const options = {
  semanticRecall: { filter: { category: { $in: ['work', 'research'] } } },
}

// Filter by project and priority
const options = {
  semanticRecall: {
    filter: {
      $and: [{ projectId: { $eq: 'project-a' } }, { priority: { $gte: 3 } }],
    },
  },
}
Embedder の設定Embedder の設定への直接リンク
Semantic recall は、メッセージを埋め込みへ変換する埋め込みモデルを使用します。Mastra では、provider/model 形式の文字列を指定してモデルルーター経由で埋め込みモデルを利用できます。また、AI SDK と互換性のある任意の埋め込みモデルも使用できます。
Model Router の使用(推奨)Model Router の使用(推奨)への直接リンク
最も簡単な方法は、オートコンプリートに対応する provider/model 形式の文字列を使用することです。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
サポートされる埋め込みモデルは次のとおりです。
- OpenAI:
text-embedding-3-small,text-embedding-3-large,text-embedding-ada-002 - Google:
gemini-embedding-001 - OpenRouter: さまざまな Provider の埋め込みモデルにアクセス
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel({
      providerId: 'openrouter',
      modelId: 'openai/text-embedding-3-small',
    }),
  }),
})
モデルルーターは、環境変数(OPENAI_API_KEY、GOOGLE_API_KEY、OPENROUTER_API_KEY)から API キーを自動検出します。Google モデルでは GOOGLE_GENERATIVE_AI_API_KEY もフォールバックとして使用されます。
AI SDK パッケージの使用AI SDK パッケージの使用への直接リンク
AI SDK の埋め込みモデルを直接使用することもできます。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
  }),
})
FastEmbed(ローカル)の使用FastEmbed(ローカル)の使用への直接リンク
ローカル埋め込みモデルの FastEmbed を使用するには、@mastra/fastembed をインストールします。
- npm
- pnpm
- Yarn
- Bun
npm install @mastra/fastembed@latest
pnpm add @mastra/fastembed@latest
yarn add @mastra/fastembed@latest
bun add @mastra/fastembed@latest
続いて Memory に設定します。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { fastembed } from '@mastra/fastembed'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: fastembed,
  }),
})
PostgreSQL インデックスの最適化PostgreSQL インデックスの最適化への直接リンク
PostgreSQL をベクトルストアとして使用する場合、ベクトルインデックスを設定することで semantic recall のパフォーマンスを最適化できます。これは、数千件のメッセージを扱う大規模なデプロイで特に重要です。
PostgreSQL は IVFFlat と HNSW の両方のインデックスに対応しています。Mastra はデフォルトで IVFFlat インデックスを作成しますが、一般に HNSW インデックスの方が高いパフォーマンスを得られます。特に、内積距離を使用する OpenAI の埋め込みで効果的です。
import { Memory } from '@mastra/memory'
import { PgStore, PgVector } from '@mastra/pg'

const agent = new Agent({
  memory: new Memory({
    storage: new PgStore({
      id: 'agent-storage',
      connectionString: process.env.DATABASE_URL,
    }),
    vector: new PgVector({
      id: 'agent-vector',
      connectionString: process.env.DATABASE_URL,
    }),
    options: {
      semanticRecall: {
        topK: 5,
        messageRange: 2,
        indexConfig: {
          type: 'hnsw', // Use HNSW for better performance
          metric: 'dotproduct', // Best for OpenAI embeddings
          m: 16, // Number of bi-directional links (default: 16)
          efConstruction: 64, // Size of candidate list during construction (default: 64)
        },
      },
    },
  }),
})
インデックス設定オプションとパフォーマンス調整の詳細については、PgVector 設定ガイドを参照してください。
Semantic recall を無効にするSemantic recall を無効にするへの直接リンク
Semantic recall はデフォルトで無効です(semanticRecall: false)。各呼び出しでは、新しいメッセージを埋め込みに変換し、LLM に渡す前にベクトルデータベースへのクエリに使用するため、レイテンシーが増加します。
次の場合は semantic recall を無効のままにしてください。
- メッセージ履歴だけで現在の会話に十分なコンテキストを提供できる場合。
- リアルタイム双方向音声など、埋め込みやベクトルクエリのレイテンシーが影響する、パフォーマンス要件の厳しいアプリケーションを構築する場合。
呼び出されたメッセージの表示呼び出されたメッセージの表示への直接リンク
Tracing を有効にすると、semantic recall で取得されたメッセージが、直近のメッセージ履歴(設定されている場合)とともに Agent の Trace 出力に表示されます。