Memory
Memory を使用すると、Agent はユーザーメッセージ、Agent の応答、Tool の結果をやり取りをまたいで記憶できます。これにより、一貫性と会話の流れを保つために必要なコンテキストが得られ、時間の経過とともにより良い回答を生成できるようになります。
Mastra Agent は、メッセージ履歴を保存するよう設定できます。さらに、次の機能を有効にできます。
- Observational Memory(推奨):バックグラウンド Agent を使用して高密度の観察ログを維持し、増大する生のメッセージ履歴を置き換えます。長期記憶を保持しながら、コンテキストウィンドウを小さく保ちます。
- working memory:名前、好み、目標など、永続的で構造化されたユーザーデータを保存します。
- セマンティックリコール:完全一致するキーワードではなく、意味に基づいて関連する過去のメッセージを取得します。
- マルチユーザースレッド:1つのスレッドを複数のユーザーで共有します。
Memory の合計がモデルのコンテキスト上限を超える場合、Memory Processorでコンテンツをフィルタリング、切り詰め、優先順位付けし、最も関連性の高い情報を保持できます。
Memory の結果は、設定した1つ以上のストレージ Providerに保存されます。
Agent が使用できる Memory レイヤーの概念的な概要については、Mastra memory conceptsをご覧ください。
Memory を使用する場面Memory を使用する場面への直接リンク
Agent が、過去のやり取りを参照する複数ターンの会話を維持する必要がある場合、セッションの以前のユーザー設定や情報を思い出す必要がある場合、または会話スレッド内で時間をかけてコンテキストを構築する必要がある場合に、Memory を使用します。各やり取りが独立している単一ターンのリクエストでは、Memory は不要です。
クイックスタートクイックスタートへの直接リンク
@mastra/memoryパッケージをインストールします。- npm
- pnpm
- Yarn
- Bun
npm install @mastra/memory@latestpnpm add @mastra/memory@latestyarn add @mastra/memory@latestbun add @mastra/memory@latestユーザーメッセージや Agent の応答を含むメッセージ履歴を永続化するには、Memory にストレージ Provider が必要です。
このクイックスタートでは、
@mastra/libsqlを使用します。- npm
- pnpm
- Yarn
- Bun
npm install @mastra/libsql@latestpnpm add @mastra/libsql@latestyarn add @mastra/libsql@latestbun add @mastra/libsql@latest利用可能な Provider と Mastra におけるストレージの仕組みについて詳しくは、ストレージのドキュメントを参照してください。
設定済みのすべての Agent で Memory を有効にするため、メインの Mastra インスタンスにストレージ Provider を追加します。
src/mastra/index.tsimport { Mastra } from '@mastra/core'import { LibSQLStore } from '@mastra/libsql'export const mastra = new Mastra({storage: new LibSQLStore({id: 'mastra-storage',url: ':memory:',}),})Memoryインスタンスを作成し、Agent のmemoryオプションに渡します。src/mastra/agents/memory-agent.tsimport { Agent } from '@mastra/core/agent'import { Memory } from '@mastra/memory'export const memoryAgent = new Agent({id: 'memory-agent',name: 'Memory Agent',memory: new Memory({options: {lastMessages: 20,},}),})設定オプションの一覧については、Memory Class を参照してください。
たとえば Studio で Agent を呼び出します。Studio で Agent との新しいチャットを開始し、右側のサイドバーを確認してください。Memory に関するさまざまな情報が表示されます。
メッセージ履歴メッセージ履歴への直接リンク
メッセージ履歴を追跡するには、resource と thread を持つ memory オブジェクトを渡します。
resource:ユーザーまたはエンティティを示す安定した識別子。thread:特定の会話またはセッションを分離する ID。
const response = await memoryAgent.generate('Remember my favorite color is blue.', {
  memory: {
    resource: 'user-123',
    thread: 'conversation-123',
  },
})
Memory に保存された情報を思い出すには、元の会話で使用したものと同じ resource と thread の値で Agent を呼び出します。
const response = await memoryAgent.generate("What's my favorite color?", {
  memory: {
    resource: 'user-123',
    thread: 'conversation-123',
  },
})

// Response: "Your favorite color is blue."
各スレッドには、作成後に変更できない所有者(resourceId)があります。所有者が異なるスレッドで同じスレッド ID を再利用しないでください。クエリ時にエラーが発生します。
リソースのすべてのスレッドを一覧表示する場合や、特定のスレッドを取得する場合は、Memory API を直接使用してください。
Observational MemoryObservational Memoryへの直接リンク
長期間続く会話では、生のメッセージ履歴がコンテキストウィンドウを埋め尽くすまで増加し、Agent のパフォーマンスが低下します。Observational Memory は、古いメッセージを高密度の観察結果に圧縮するバックグラウンド Agent を実行することで、この問題を解決します。長期記憶を保持しながら、コンテキストウィンドウを小さく保ちます。
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'

export const memoryAgent = new Agent({
  id: 'memory-agent',
  name: 'Memory Agent',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
観察とリフレクションの仕組みについて詳しくは Observational Memory を、すべての設定オプションについてはリファレンスを参照してください。
モデルに表示される内容モデルに表示される内容への直接リンク
各 Memory 機能は、モデルに送信されるリクエストのシステムメッセージまたは会話メッセージに追加されます。レイヤーは、有効にした機能によって異なります。working memory とセマンティックリコールは、設定されている場合にのみ表示されます。Observational Memory も同様ですが、メッセージ履歴はデフォルトで有効です。図は、有効にした各レイヤーがリクエスト内のどこに配置されるかを示しています。以下では、各レイヤーが提供する内容について説明します。
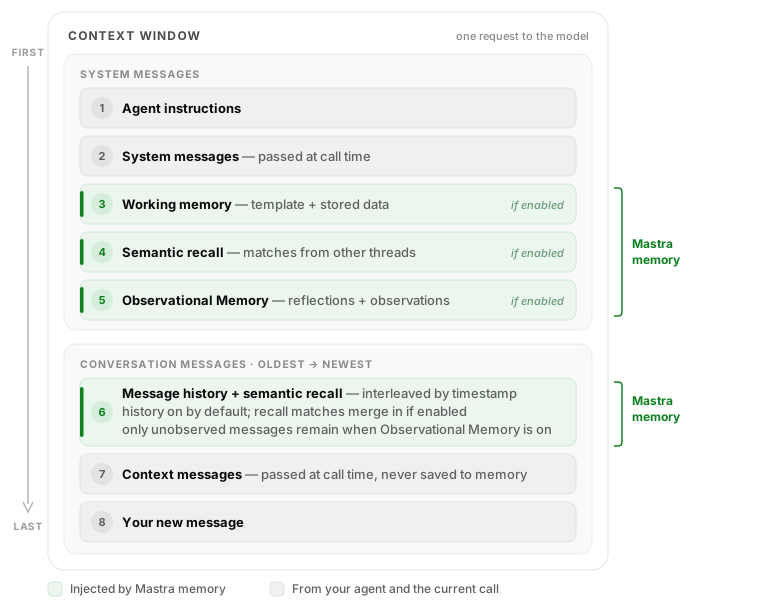
- working memory は、テンプレートと保存されたデータを含むシステムメッセージとして挿入されます。
useStateSignalsを使用すると、代わりに state signal として提供されます。 - セマンティックリコールによる現在のスレッドからの一致結果は、通常のメッセージとして挿入され、タイムスタンプに基づいてメッセージ履歴と混在します。他のスレッドからの一致結果は、代わりにシステムメッセージとして整形されます。
- メッセージ履歴は、直近の N 件のメッセージを時系列順に追加します。新しいメッセージは常に最後に配置されます。
- Observational Memory は、古い生の履歴を置き換えます。リフレクションと観察結果はシステムメッセージに格納され、まだ観察されていないメッセージだけが会話に残ります。短い継続リマインダーが会話メッセージの先頭に配置されます。
- コンテキストメッセージは、呼び出し時に渡す任意の
context配列です。たとえば、agent.generate(msg, { context: [...] })のように指定します。アプリの状態や独自の RAG 結果など、1回限りの背景情報に使用します。そのリクエストでのみ通常の会話メッセージとして表示され、Memory には保存されません。
会話メッセージはタイムスタンプ順に並べられ、メッセージ ID によって重複が排除されます。そのため、呼び出された古いメッセージは最近の履歴より前に表示されます。呼び出し時に渡されたコンテキストメッセージには現在時刻が記録され、履歴とリコールの後、新しいメッセージの前に配置されます。実際のリクエストの正確なコンテキストを確認するには、Tracing を使用して LLM 呼び出しの span を開いてください。詳しくは後述の可観測性を参照してください。
マルチ Agent システムでの Memoryマルチ Agent システムでの Memoryへの直接リンク
supervisor Agent がサブ Agent に委任すると、Mastra はサブ Agent の Memory を自動的に分離します。この処理は委任のたびに行われるため、有効化するためのフラグはありません。このスコープの仕組みを理解することで、非公開にする情報と意図的に共有する情報を判断できます。
委任による Memory のスコープ委任による Memory のスコープへの直接リンク
委任のたびに、サブ Agent 用の新しい threadId と確定的な resourceId が作成されます。
- スレッド ID:委任ごとに一意です。サブ Agent は呼び出されるたびに、空のメッセージ履歴から開始します。
- リソース ID:
{parentResourceId}-{agentName}として生成されます。リソース ID は委任をまたいで安定しているため、リソーススコープの Memory は呼び出し間で保持されます。サブ Agent は、同じユーザーによる以前の委任で得た情報を記憶します。 - Memory インスタンス:独自の Memory を持たないサブ Agent は、supervisor の
Memoryインスタンスと設定済みのすべてのオプションを継承します。サブ Agent が独自のものを定義している場合は、そちらが優先されます。
タイトル生成(generateTitle)はトップレベルのスレッドに関する処理であり、継承されたサブ Agent のスレッドには適用されません。委任のたびに誰にも表示されない一時的なスレッドが作成されるため、タイトルを生成すると委任ごとに LLM 呼び出しが無駄に発生します。サブ Agent 独自のスレッドにタイトルを生成するには、そのサブ Agent に独自の Memory 設定を指定してください。
supervisor は会話のコンテキストをサブ Agent に転送するため、サブ Agent はタスクの完了に必要な背景情報を取得できます。保存されるのは委任プロンプトとサブ Agent の応答だけで、親の会話全体は保存されません。messageFilter コールバックを使用すると、どのメッセージをサブ Agent に渡すかを制御できます。
サブ Agent のリソース ID には、常に Agent 名のサフィックス({parentResourceId}-{agentName})が付きます。同じ supervisor 配下の異なるサブ Agent が、委任を通じて同じリソース ID を共有することはありません。
このデフォルトの分離を超えて Memory を共有するには、Agent を直接呼び出す際に同じ識別子を渡します。
Agent 間で Memory を共有するAgent 間で Memory を共有するへの直接リンク
Agent を直接呼び出す場合(委任フローの外部)、Memory の共有は resourceId と threadId という2つの識別子によって制御されます。同じ値を使用する Agent は、同じデータを読み書きします。たとえば、調査担当がメモを保存し、執筆担当がそのメモを読むといった、共有コンテキストで Agent が連携する場合に役立ちます。
リソーススコープの共有は、最も一般的なパターンです。working memory とセマンティックリコールのデフォルトは scope: 'resource' です。2つの Agent が resourceId を共有すると、異なるスレッド間でも観察結果、working memory、Embedding を共有します。
// Both agents share the same resource-scoped memory
await researcher.generate('Find information about quantum computing.', {
  memory: { resource: 'project-42', thread: 'research-session' },
})

await writer.generate('Write a summary from the research notes.', {
  memory: { resource: 'project-42', thread: 'writing-session' },
})
両方の呼び出しで resource: 'project-42' を使用しているため、執筆担当は調査担当の観察結果と working memory にアクセスできます。セマンティック Embedding もリソースを通じて共有されます。各 Agent は独自のスレッドを持つため、メッセージ履歴は分離されたままです。
スレッドスコープの共有では、より密接に連携できます。Observational Memory のデフォルトは scope: 'thread' です。2つの Agent が同じ resource と thread を使用すると、メッセージ履歴全体を共有します。各 Agent は、もう一方が書き込んだすべてのメッセージを確認できます。Agent が互いの正確な出力を基に作業する必要がある場合に役立ちます。
可観測性可観測性への直接リンク
Tracing を有効にして、動作中の Memory を監視およびデバッグします。Trace では、Agent が各リクエストのコンテキストに含めたメッセージと観察結果を正確に確認できるため、Agent の動作を理解し、Memory の取得が想定どおりに機能しているか検証できます。
Studio を開き、サイドバーの Observability タブを選択します。最近の Agent リクエストの Trace を開き、LLM 呼び出しの span を探してください。
リクエストごとに Memory を切り替えるリクエストごとに Memory を切り替えるへの直接リンク
リクエスト固有の値にアクセスするには、RequestContext を使用します。これにより、リクエストのコンテキストに基づいて、異なる Memory またはストレージ設定を条件付きで選択できます。
export type UserTier = {
  'user-tier': 'enterprise' | 'pro'
}

const premiumMemory = new Memory()
const standardMemory = new Memory()

export const memoryAgent = new Agent({
  id: 'memory-agent',
  name: 'Memory Agent',
  memory: ({ requestContext }) => {
    const userTier = requestContext.get('user-tier') as UserTier['user-tier']

    return userTier === 'enterprise' ? premiumMemory : standardMemory
  },
})
詳しくは、Request Context を参照してください。
関連項目関連項目への直接リンク
Memoryリファレンス- Tracing
- Request Context
- Mastra Code:Mastra の Memory システムを使用するコーディング Agent