Observational Memory
追加バージョン: @mastra/memory@1.1.0
Observational Memory(OM)は、長いコンテキストを扱う Agent 向けの Mastra のメモリシステムです。バックグラウンド Agent である Observer と Reflector が Agent の会話を監視し、増え続ける生のメッセージ履歴を置き換える、情報密度の高い観察ログを維持します。
クイックスタートクイックスタートへの直接リンク
プロジェクトに @mastra/memory がインストールされていることを確認してください。Memory の設定で observationalMemory: true を指定すると、Observational Memory が有効になります。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
これで Agent は、会話をまたいで保持される人間のような長期記憶を備えます。observationalMemory: true を指定すると、デフォルトで google/gemini-2.5-flash が使用されます。別のモデルを使用するには、設定オブジェクトで指定します。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
API の詳細については、設定オプションを参照してください。
クライアントアプリケーションで OM を使用する場合、会話履歴全体ではなく、クライアントから新しいメッセージだけを送信してください。
Observational Memory は保存済みの会話履歴を引き続き使用します。履歴全体の送信は冗長であり、クライアント側のタイムスタンプが保存済みのタイムスタンプと競合すると、メッセージ順序の不具合を引き起こす可能性があります。
AI SDK の例については、Mastra Memory の使用を参照してください。
現在、OM が対応しているストレージアダプターは、@mastra/pg、@mastra/libsql、@mastra/mysql、@mastra/mongodb、@mastra/convex、@mastra/oracledb のみです。
メモリ管理にはバックグラウンド Agent を使用します。モデルを設定しない場合、デフォルトモデルは google/gemini-2.5-flash です。
時間的な間隔マーカー時間的な間隔マーカーへの直接リンク
時間的な間隔マーカーは、スレッド内の前のメッセージから十分な時間が経過した場合、新しいユーザーメッセージの前に短い通知を挿入します。これにより、Agent と UI は、一定の中断後に会話が再開されたことを把握できます。
時間的な間隔マーカーはデフォルトで無効です。observationalMemory の設定で temporalMarkers: true を指定して有効にします。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
Mastra は、間隔が 10 分以上の場合に時間的な間隔マーカーを挿入します。マーカーはメモリに保存され、一時的な通知イベントとしても発行されるため、クライアントは簡潔なタイムライン上のヒントとして表示できます。
Observer がスレッドを処理する際にもこれらのマーカーを参照するため、書き込まれる観察結果に出来事の発生時期を関連付けられます(例: 「ユーザーは 2 日間の中断後にデプロイについて質問した」)。
完全な設定形式については、API リファレンスを参照してください。
早期有効化早期有効化への直接リンク
OM は、トークンしきい値に達する前に、バッファー済みの観察結果を有効化できます。プロンプトキャッシュの有効期限が近い場合や、Agent がモデル Provider を切り替える場合に役立ちます。
最上位の早期有効化設定は、デフォルトで観察処理に適用されます。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
フェーズごとに制御するには、ネストした observation と reflection の設定を使用します。Reflection の早期有効化は明示的に指定する必要があるため、最上位の設定は観察処理にのみ影響します。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
この例では、最上位のアイドル設定は観察処理では無効になり、Reflection ではアイドル時および Provider 変更時の有効化が明示的に有効になります。
アイドル時のバッファリングアイドル時のバッファリングへの直接リンク
Agent のターンが終了してアイドル状態になったときに、バックグラウンドで観察結果をバッファリングするには、observation.bufferOnIdle を true に設定します。次のターンや messageTokens のしきい値を待たずに、短いターンも観察対象にしたいアプリに役立ちます。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle はデフォルトで無効です。これは bufferTokens とは別の設定です。bufferTokens はステップ実行中の非同期バッファリングを制御し、bufferOnIdle はアイドル状態になるターンの終了時バッファリングを制御します。
完全な設定形式については、API リファレンスを参照してください。
利点利点への直接リンク
- プロンプトキャッシュ: OM のコンテキストは安定しており、観察結果は各ターンの実行時に取得されるのではなく、時間の経過とともに追記されます。これによりプロンプトのプレフィックスをキャッシュでき、コストを削減できます。
- 圧縮: 生のメッセージ履歴と Tool の結果が、情報密度の高い観察ログへ圧縮されます。コンテキストが小さくなるため、応答が速くなり、一貫性のある会話を長く続けられます。
- コンテキスト劣化の防止: Agent には、ノイズの多い Tool 呼び出しや不要なトークンではなく、関連情報が提示されるため、長いセッションでもタスクに集中できます。
仕組み仕組みへの直接リンク
人は、これまで交わしたすべての会話を一語一句記憶しているわけではありません。起きたことを無意識に観察した後、脳が振り返り、再編成し、結び付け、要約して長期記憶にします。OM も同じように動作します。
Agent が応答するたびに、システムプロンプト、最近のメッセージ履歴、挿入されたコンテキストを含むコンテキストウィンドウが提示されます。コンテキストウィンドウには限りがあります。トークン上限が大きいモデルでも、ウィンドウが一杯になると性能が低下します。これにより、次の 2 つの問題が生じます。
- コンテキスト劣化: Agent が保持する生のメッセージ履歴が増えるほど、性能が低下します。
- コンテキストの浪費: 履歴の大部分には、Agent がタスクを続けるうえで不要になったトークンが含まれます。
OM は古いコンテキストを情報密度の高い観察結果へ圧縮し、両方の問題を解決します。
観察結果観察結果への直接リンク
メッセージ履歴のトークン数がしきい値(デフォルト: 30,000)を超えると、Observer は起きたことを簡潔にまとめた観察結果を作成します。
OM は、このしきい値判定に高速なローカルトークン推定を使用します。テキストは tokenx で推定し、画像部分には Provider を考慮したヒューリスティクスを使用するため、マルチモーダルな会話でも適切なタイミングで観察処理が実行されます。転送処理によってアップロード画像が画像部分ではなくファイルとして正規化される場合、画像に似た file 部分にも同じ処理が適用されます。たとえば、OpenAI の画像詳細設定は、OM が観察処理を実行するタイミングに大きく影響することがあります。
Observer は、確認する履歴内の添付ファイルも参照できます。OM は読みやすさのため、[Image #1: reference-board.png] や [File #1: floorplan.pdf] のようなプレースホルダーをトランスクリプトに残し、実際の添付ファイル部分をテキストとともに転送します。画像に似た file 部分は、可能であれば Observer 用の画像入力に昇格されます。画像以外の添付ファイルは、トークン数を正規化したファイル部分として転送されます。これは通常のスレッド観察と、リソーススコープでの一括観察の両方に適用されます。
ExtractorExtractorへの直接リンク
観察結果とともに特定の値を OM に保持させるには、Extractor を使用します。現在のタスク、推奨応答、スレッドタイトルなどの組み込み値にも、カスタム値と同じ抽出パイプラインが使用されます。
次の例では、観察結果から簡潔なユーザープロファイルを抽出します。
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
schema を追加すると、Extractor は後続の構造化出力リクエストとして実行されます。スキーマのない Extractor は、Observer または Reflector の応答で直接出力されるインライン文字列 Extractor です。
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
デフォルトでは、OM は後続の実行時に、前回抽出した値を Extractor に提示します。Observer に前回の値を見せない場合は、includePreviousExtraction: false を設定します。
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
Extractor が、アクティブなメモリインスタンスやリクエストコンテキストなどの実行時コンテキストを必要とする場合は、実行時の instructions 関数または schema 関数を使用します。
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
ストリームから抽出値を読み取るストリームから抽出値を読み取るへの直接リンク
OM が観察または Reflection を完了すると、Extractor の結果が出力されます。ストリームから両方の完了データ部分を読み取ります。
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues は各 Extractor の slug をキーとして使用します。どちらの結果フィールドも任意であり、ある Extractor が失敗しても、成功した Extractor の値は削除されません。
data-om-observation-end は同期処理の完了を報告します。data-om-buffering-end はバックグラウンド処理の完了を報告します。Extractor のメタデータは直ちに保持されますが、バッファーされた内容は有効化されるまで非アクティブなままです。完了した処理が観察と Reflection のどちらであるかは、operationType で確認します。
完全なペイロードについては、data-om-observation-end と data-om-buffering-end のリファレンス表を参照してください。
Working Memory の更新Working Memory の更新への直接リンク
Observer に Working Memory を自動管理させるには、observationalMemory.observation.manageWorkingMemory を使用します。メイン Agent はユーザーリクエストを処理している間に Working Memory Tool を呼び出す必要がなくなるため、Working Memory の更新が Agent の呼び出し忘れに左右されません。
これにより、Working Memory もプロンプトキャッシュと相性のよい状態に保たれます。通常、Working Memory はシステムプロンプト内にあるため、更新によってプロンプトキャッシュが無効になることがあります。OM が管理する Working Memory では、デフォルトで workingMemory.useStateSignals が true になり、Working Memory は代わりに状態シグナルへ移動します。
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
この設定により WorkingMemoryExtractor が追加され、workingMemory.agentManaged のデフォルトは false、workingMemory.useStateSignals のデフォルトは true になります。メイン Agent に引き続き Working Memory Tool と指示を挿入する場合は、workingMemory.agentManaged: true を設定します。
カスタム抽出値を保持する前に正規化したり、その値に応じた処理を実行したりするには、onExtracted を使用します。
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
Extractor の失敗は OM マーカーで報告され、成功した他の Extractor の値を妨げません。Extractor の完全な形式については、API リファレンスを参照してください。
Observer のモデルがテキスト専用の場合や、その API がマルチモーダル入力を拒否する場合は、observation.observeAttachments を false に設定し、添付ファイルが Observer に届く前に除外します。読みやすいプレースホルダー([Image #1: ...]、[File #1: ...])はトランスクリプトに残るため、Observer はバイナリペイロードを受け取らなくても、共有された内容を推論できます。同じフィルターは、画像またはファイル部分を含む Tool の結果にも適用されます。
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
mimeType の glob の許可リスト(例: ['image/*'])を渡して、Observer が処理できる種類だけを転送することもできます。または observeAttachments: 'auto' を設定すると、Mastra が Provider の機能レジストリを基に判断します。Observer のモデルがマルチモーダル入力に対応している場合は添付ファイルを転送し、対応していない場合は除外します。モデルの機能データがない場合は true にフォールバックします。
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
通常、圧縮率は 5 倍から 40 倍です。Observer は、Agent が中断した箇所から再開できるように、現在のタスクと推奨応答も追跡します。
observation.threadTitle を有効にすると、会話のトピックが大きく変わったときに、Observer が短いスレッドタイトルを提案できます。スレッドタイトルの生成は明示的な指定が必要で、スレッドのメタデータを更新します。そのため、Mastra Code などのアプリは、スレッド一覧やステータス UI に最新のタイトルを表示できます。
例として、Playwright MCP を使用する Agent では、ページのスナップショットごとに 50,000 トークン以上が提示されることがあります。OM を使用すると、Observer が操作を監視し、ページの内容と実行された操作を数百トークンの観察結果にまとめます。Agent はすべての生のスナップショットを保持せずにタスクへ集中できます。
ReflectionReflectionへの直接リンク
観察結果がしきい値(デフォルト: 40,000 トークン)を超えると、Reflector は内容を圧縮し、関連項目を結合して、パターンを振り返ります。
Reflection は、独立して増え続ける別レイヤーとして蓄積されるわけではありません。各 Reflection は観察ログ全体を書き換えます。Reflector の出力が新しいログになり、その後に新しい観察結果が追記されます。ログが次にしきい値へ達すると、Reflector は以前の Reflection を含むすべてを再処理します。新しい詳細を維持しながら、古い情報をより積極的に圧縮します。会話がどれだけ長く続いても、メモリは Reflection のしきい値付近に収まります。
その結果、次の 3 階層のシステムになります。
- 最近のメッセージ: 現在のタスクに関する正確な会話履歴
- 観察結果: Observer が確認した内容のログ
- Reflection: メモリが長くなりすぎたときに圧縮された観察結果
コンテキストの時間的な変化コンテキストの時間的な変化への直接リンク
デフォルト設定では、コンテキストウィンドウは無制限に増えません。観察と縮小を繰り返すサイクルで増減します。
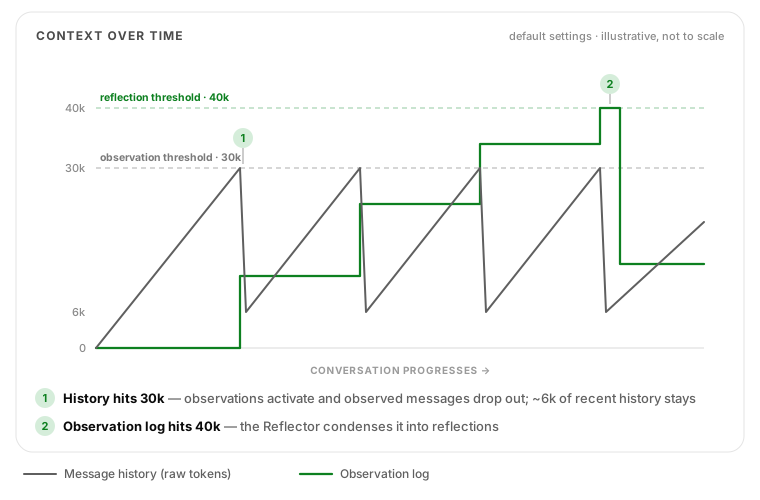
- 0 → 30k トークン: メッセージ履歴は通常どおり増加します。バックグラウンドでは、Observer が約 6k トークンごとに観察結果をバッファリングします(
bufferTokens: 0.2)。 - 30k に到達: バッファー済みの観察結果が直ちに有効になります。観察済みのメッセージはコンテキストウィンドウから削除され、最近の履歴約 6k トークンだけが残ります(
bufferActivation: 0.8はしきい値の 20% を保持)。削除された約 24k トークンのメッセージは、通常 5~40 倍の圧縮により、約 1~5k トークンの観察結果になります。 - 繰り返し: 履歴は約 6k から再び 30k に近づくまで増え、また縮小します。サイクルごとに観察ログへ追記されますが、生の履歴よりはるかに緩やかに増加します。
- 観察結果が 40k に到達: Reflector が、現在の観察結果と以前の Reflection から、より小さなログを作成します。
通常のバッファリングサイクルでは、生の履歴はおよそ 6k~30k トークンの範囲で増減します。会話がどれだけ長く続いても、観察ログは約 40k トークンに保たれます。これらはハード上限ではなく、有効化のしきい値です。バックグラウンドのバッファリングが追いつかない場合、blockAfter(デフォルト: 1.2)が安全上限として約 36k トークン(Reflection では約 48k)で同期観察を強制するまで、履歴がしきい値を超えて増えることがあります。
shareTokenBudget を有効にすると、2 つの予算がまとめて使用されます。観察ログが小さい間は、観察処理が実行される前に、メッセージ履歴が未使用の観察領域まで拡張できます(デフォルトでは最大約 70k トークン)。その後、観察結果の蓄積に伴って縮小します。
取得モード取得モードへの直接リンク
通常の OM はメッセージを観察結果へ圧縮するため、タスクへの集中には適していますが、元の表現は失われます。取得モードでは、各観察結果のグループを、その生成元となった生のメッセージと関連付けたままにすることで、この問題を解決します。要約で失われた正確な表現、Tool の出力、時系列が必要になった場合、Agent は recall Tool を呼び出し、元のメッセージをページ単位で確認できます。
閲覧のみ閲覧のみへの直接リンク
生のメッセージを閲覧する recall Tool を有効にするには、retrieval: true を設定します。ベクトルストアは不要です。デフォルトでは、recall Tool は現在のリソースに属するすべてのスレッドを閲覧できます。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
セマンティック検索を併用するセマンティック検索を併用するへの直接リンク
セマンティック検索も有効にするには、retrieval: { vector: true } を設定します。Memory インスタンスにすでに設定されているベクトルストアと Embedder が再利用されます。
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
ベクトル検索を設定すると、新しい観察グループはバッファリング時および同期観察時に自動的にインデックス化されます(fire-and-forget 方式のノンブロッキング処理)。セマンティック検索は、生のソースメッセージ ID の範囲を伴う観察グループの一致結果を返します。そのため recall Tool は、要約されたメモリをその生成元とともに表示できます。
現在のスレッドに限定する現在のスレッドに限定するへの直接リンク
デフォルトの recall Tool のスコープは 'resource' です。Agent はスレッドの一覧表示、他のスレッドの閲覧、すべての会話を横断した検索ができます。Agent を現在のスレッドのみに限定するには、scope: 'thread' を設定します。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
recall のカスタムガイダンスrecall のカスタムガイダンスへの直接リンク
Mastra は、検索、スレッドの一覧表示、特定スレッドの読み取りを実行するタイミングを Agent に教える、スコープ対応の指示を挿入します。組み込み指示の後にアプリ固有のガイダンスを追加するには、instructions を使用します。組み込み指示が置き換えられることはありません。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
これにより、recall 固有のガイダンスは Agent のグローバルな指示ではなく recall Tool に関連付けられるため、無関係なタスクには影響しません。
取得モードで有効になる機能取得モードで有効になる機能への直接リンク
取得モードを有効にすると、OM は次の処理を行います。
- 各観察グループに、生成元のメッセージを指す
range(例:startId:endId)を保存する - Agent がどの観察結果とどのメッセージが対応するか把握できるように、Agent のコンテキスト内に範囲のメタデータを表示する
- Agent が呼び出せる
recallTool を登録し、次の操作を可能にする- 任意の観察グループ範囲の元になった生のメッセージをページ単位で確認する
- セマンティック類似度で検索する(
query文字列を指定したmode: "search")。vector: trueが必要 - すべてのスレッドを一覧表示(
mode: "threads")し、他のスレッドを閲覧(threadId)して、すべてのスレッドを横断して検索する(デフォルトのscope: 'resource') scope: 'thread'の場合、閲覧と検索を現在のスレッドだけに限定する
完全な API(詳細レベル、部分インデックス、ページネーション、スレッド横断の閲覧、トークン制限)については、recall Tool リファレンスを参照してください。
StudioStudioへの直接リンク
実際の動作を確認するには、Studio を開き、OM を有効にした Agent に移動します。Memory タブには、次の内容が表示されます。
-
トークン進捗バー: メッセージと観察結果の現在のトークン数、および各しきい値までの進捗を表示します。情報アイコンにカーソルを合わせると、Observer と Reflector のモデルとしきい値を確認できます。
-
有効な観察結果: 現在の観察ログがインライン表示されます。以前の観察または Reflection の記録がある場合は、「Previous observations」を展開して参照できます。
-
バックグラウンド処理: 会話中、Agent がバックグラウンドで処理する際に、バッファー済みの観察チャンクと Reflection のステータスが表示されます。
Agent が観察または Reflection を実行している間、進捗バーはリアルタイムで更新され、経過時間とステータスバッジが表示されます。
モデルモデルへの直接リンク
Observer と Reflector はバックグラウンドで実行されます。Mastra のモデルルーティング(provider/model)で動作するモデルであれば、どれでも使用できます。モデルを設定しない場合、デフォルトモデルは google/gemini-2.5-flash です。
Mastra では、大きなコンテキストウィンドウ(128K トークン以上)を持ち、操作を遅延させずバックグラウンドで実行できる十分な速度のモデルを推奨します。
使用するモデルが不明な場合は、デフォルトの google/gemini-2.5-flash から始めてください。openai/gpt-5-mini、anthropic/claude-haiku-4-5、deepseek/deepseek-reasoner、deepseek/deepseek-v4-pro、deepseek/deepseek-v4-flash、xai/grok-4-1-fast、qwen3、glm-4.7 でも動作を確認しています。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
Agent ごとに異なるモデルを使用する方法については、モデル設定を参照してください。
google/gemini-2.5-flash は、長い出力でも詳細を保持する能力が特に優れています。そのため、最大回数の圧縮再試行後も、Reflector が設定済みの reflection.observationTokens しきい値を超える Reflection を生成することがあります。この場合、無限ループを避けるため、Reflector は再試行で生成された、内容を失っていない候補のうち最小のものを返します。
Reflector でさらに強い圧縮を行う場合は、xai/grok-4-1-fast、deepseek/deepseek-v4-pro、deepseek/deepseek-v4-flash など、より積極的に要約するモデルへ切り替えてください。Observer には google/gemini-2.5-flash を使い続け、Reflector には別のモデルを使用できます。Agent ごとに異なるモデルを参照してください。
トークン数に応じたモデル選択トークン数に応じたモデル選択への直接リンク
追加バージョン: @mastra/memory@1.10.0
ModelByInputTokens を使用すると、入力トークン数に基づいて異なる Observer または Reflector のモデルを指定できます。OM は実行時に、設定された upTo しきい値から一致するモデル階層を選択します。
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
upTo のキーは、それぞれ上限値を含みます。OM は Observer または Reflector 呼び出しの実際の入力トークン数を計算し、一致する階層を直接解決して、その具体的なモデルを実行に使用します。
入力が設定済みの最大しきい値を超えるとエラーがスローされます。しきい値が想定される入力サイズの全範囲をカバーするようにするか、最上位の階層で十分に大きなコンテキストウィンドウを持つモデルを使用してください。
スコープスコープへの直接リンク
スレッドスコープ(デフォルト)スレッドスコープ(デフォルト)への直接リンク
各スレッドが独自の観察結果を持ちます。このスコープは十分にテストされており、特に長期にわたる Agent のユースケースで、汎用メモリシステムとして適切に動作します。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
スレッドスコープでは、Agent を呼び出す際に有効な threadId を指定する必要があります。threadId がない場合、Observational Memory はエラーをスローします。これにより、複数のスレッドが意図せず 1 つの観察レコードを共有し、データベースのデッドロックを引き起こすことを防ぎます。
リソーススコープ(実験的)リソーススコープ(実験的)への直接リンク
観察結果は、リソース(通常はユーザー)に属するすべてのスレッド間で共有されます。これにより、会話をまたぐメモリが利用できます。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'resource',
    },
  },
})
リソーススコープは動作しますが、同時進行する複数スレッド間でのタスク追従性と継続性が実証されるまでは、実験的機能です。 現時点では、あるスレッドが、別のスレッドですでに開始された(ただし未完了の)作業を続行しないように、システムプロンプトの調整が必要になる場合があります。
これは、リソーススコープでは各スレッドが、そのリソースに属する_すべての_スレッドを対象とした視点になるためです。
ユースケースによっては問題にならないため、実際の結果は状況により異なります。
リソーススコープでは、_すべての_スレッドにある未観察のメッセージがまとめて処理されます。既存スレッドが多いユーザーの場合、処理に時間がかかることがあります。既存のアプリではスレッドスコープを使用してください。
トークン予算トークン予算への直接リンク
OM はトークンしきい値を使用して、観察と Reflection の実行タイミングを決定します。詳細については、トークン予算の設定を参照してください。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
トークンカウントのキャッシュトークンカウントのキャッシュへの直接リンク
OM は、しきい値の確認やバッファリング判断で繰り返しカウントする処理を減らすため、メッセージのメタデータにトークン推定値をキャッシュします。
- 部分ごとの推定値は
part.providerMetadata.mastraに保存され、キャッシュバージョンと tokenizer のソースが一致する場合、後続の処理で再利用されます。 - 部分を持たない文字列のみのメッセージ内容には、メッセージレベルのメタデータによるフォールバックキャッシュが使用されます。
- メッセージと会話のオーバーヘッドは、毎回再計算されます。キャッシュに保存されるのはペイロードの推定値だけなので、カウントの動作は変わりません。
data-*部分とreasoning部分は引き続き除外され、キャッシュもされません。
呼び出し元が指定するファイル部分のトークン推定値呼び出し元が指定するファイル部分のトークン推定値への直接リンク
providerMetadata.mastra.tokenEstimate を使用すると、image または file 部分にトークン推定値を直接付加できます。Token Counter はこの値をそのまま採用し、独自の推定処理を省略します。
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
tokenEstimate オブジェクトは、Token Counter が内部でキャッシュした推定値に使用する形式と同じです。
v: キャッシュスキーマのバージョン。0を設定します。呼び出し元が指定したエントリはフレームワークのバージョン確認対象外なので、この値は読み取られません。source: キャッシュの生成元マーカー。'client'でなければなりません。この値により、Token Counter はエントリが正式な値であり、再計算や上書きをせず、そのまま採用すべきだと判断します。key: 内容のフィンガープリント用スロット。'client'を設定します。フレームワークのエントリでは、ペイロードが変更された際に無効化できるよう、ここに内容のハッシュを使用します。'client'センチネルにより、呼び出し元の推定値は書き込み後も維持されます。tokens: 使用するトークン数。有限の非負数でなければなりません。
補足事項:
- 推定値が使用されるのは
imageとfile部分だけです。text部分とtool-invocation部分は、tokenEstimateが付加されていても常に通常どおりカウントされます。
非同期バッファリング非同期バッファリングへの直接リンク
非同期バッファリングを使用しない場合、メッセージのしきい値に達すると Observer が同期的に実行され、Observer の LLM 呼び出しが完了するまで Agent は会話の途中で一時停止します。非同期バッファリング(デフォルトで有効)を使用すると、会話の進行中にバックグラウンドで観察結果を事前計算できます。しきい値へ達すると、バッファー済みの観察結果が一時停止なしで直ちに有効になります。
仕組み仕組みへの直接リンク
Agent が会話を続けると、メッセージのトークンが蓄積します。一定間隔(bufferTokens)で、Agent をブロックせずにバックグラウンドの Observer 呼び出しが実行されます。各呼び出しは観察結果の「チャンク」を生成し、バッファーに保存します。
メッセージのトークン数が messageTokens のしきい値へ達すると、バッファー済みのチャンクが有効になります。観察結果が有効な観察ログへ移動し、対応する生のメッセージがコンテキストウィンドウから削除されます。Agent が一時停止することはありません。
バッファー済みの観察結果には、推奨される次の応答や現在のタスクなど、会話を続けるためのヒントも含まれます。そのため、有効化によってコンテキストウィンドウが縮小した後も、メイン Agent は会話の一貫性を維持できます。
Agent が Observer の処理速度を上回るペースでメッセージを生成する場合、最後の手段として blockAfter の安全しきい値が同期観察を強制します。バッファーの有効化後も、残すべき最小コンテキスト(約 1k トークンと設定済み保持下限の小さい方)は維持されます。
Reflection も同様に動作し、観察結果が Reflection のしきい値に対する一定割合へ達すると、Reflector がバックグラウンドで実行されます。
設定設定への直接リンク
| 設定 | デフォルト | 制御する内容 |
|---|---|---|
observation.bufferTokens | 0.2 | バッファリングの頻度。0.2 は messageTokens の 20% ごとを意味します。デフォルトのしきい値 30k では、約 6k トークンごとです。絶対トークン数(例: 5000)も指定できます。 |
observation.bufferActivation | 0.8 | 有効化時にメッセージウィンドウをどの程度縮小するか。0.8 は、messageTokens の 20% だけが残るようにメッセージを削除することを意味します。値を小さくすると、より多くのメッセージ履歴が残ります。 |
observation.blockAfter | 1.2 | バッファリングが追いつかない場合の安全策。1 以上 100 未満の値は messageTokens の乗数になります。1.2 の場合、36k トークン(1.2 × 30k)で同期観察が強制されます。100 以上の値は絶対トークン数(例: 50_000)です。 |
activateAfterIdle | なし | 一定期間操作がなく、observation.messageTokens に達していなくても、バッファー済みの観察結果を強制的に有効化します。300_000 のようなミリ秒単位の数値、"5m" や "1hr" のような期間文字列、または Provider に応じたプロンプトキャッシュ TTL を使用する "auto" を指定できます。 |
activateOnProviderChange | false | 次のステップで、直近のアシスタントステップを生成したものとは異なる provider/model を使用するとき、バッファー済みの観察結果を強制的に有効化します。Provider やモデルの切り替えによってプロンプトキャッシュを再利用できなくなる場合に使用します。 |
reflection.bufferActivation | 0.5 | バックグラウンド Reflection を開始するタイミング。0.5 は、観察結果が observationTokens しきい値の 50% に達すると Reflection を開始することを意味します。 |
reflection.activateAfterIdle | なし | バッファー済みの Reflection に対してアイドル時の有効化を明示的に有効にします。Reflection は最上位の activateAfterIdle を継承しません。 |
reflection.activateOnProviderChange | false | バッファー済みの Reflection に対して Provider 変更時の有効化を明示的に有効にします。Reflection は最上位の activateOnProviderChange を継承しません。 |
reflection.blockAfter | 1.2 | Reflection の安全しきい値。観察処理と同じ仕組みです。 |
プロンプトキャッシュを利用する場合は、activateAfterIdle を "auto" または特定のキャッシュ TTL に設定してください。スレッドがキャッシュの有効期限を超えてアイドル状態になると、次のリクエストでは先にバッファー済みの観察結果を有効化し、大きな生のメッセージウィンドウではなく、圧縮された小さなコンテキストウィンドウを送信できます。
"auto" の場合、Mastra はアクティブなモデル Provider からアイドル有効化の TTL を選択します。
| Provider | 自動 TTL |
|---|---|
| Anthropic、OpenRouter、不明な Provider、xAI | 5 分 |
| DeepSeek | 1 時間 |
| Google Gemini | 24 時間 |
| Groq | 2 時間 |
providerOptions.openai.promptCacheRetention: "24h" を使用する OpenAI | 1 時間 |
providerOptions.openai.promptCacheRetention: "in_memory" を使用する OpenAI | 5 分 |
OpenAI の gpt-4*、gpt-5、gpt-5-*、gpt-5.1 から gpt-5.4(- 接尾辞の派生モデルを含む) | 5 分 |
| その他の OpenAI モデル | 1 時間 |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
"auto" の場合、アクティブな Provider のプロンプトキャッシュ動作に基づいて、バッファー済みの観察結果が有効になります。そのため、次のキャッシュされていないプロンプトでは、大きな生のメッセージウィンドウではなく、圧縮された観察結果が使用されます。固定の 5 分 TTL を使用する場合は、"5m" または 300_000 を指定します。
スレッドの途中でモデルまたは Provider を変更すると、プロンプトキャッシュが無効になります。Agent がスレッドの途中で Provider またはモデルを切り替える可能性がある場合、activateOnProviderChange: true を指定すると、新しい Provider の実行前にバッファー済みの観察結果が強制的に有効になります。これにより、以前のプロンプトキャッシュを再利用できない Provider に、大きな生のウィンドウを送信せずに済みます。
無効化無効化への直接リンク
非同期バッファリングを無効にし、代わりに同期的な観察と Reflection を使用するには、次のように設定します。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
bufferTokens: false を設定すると、観察と Reflection の両方で非同期バッファリングが無効になります。完全な API については、非同期バッファリングの設定を参照してください。
非同期バッファリングは scope: 'resource' ではサポートされません。リソーススコープでは自動的に無効になります。
Observer のコンテキスト最適化Observer のコンテキスト最適化への直接リンク
デフォルトでは、新しいメッセージを処理する際、Observer は観察履歴全体をコンテキストとして受け取ります。Observer は以前の current-task と suggested-response のメタデータ(存在する場合)も受け取るため、観察コンテキストが切り詰められていても状況を把握できます。観察結果が大きくなる長期的な会話では、コンテキスト最適化を有効にして Observer の入力コストを削減できます。
Observer に送信する以前の観察結果のトークン数を制限するには、observation.previousObserverTokens を設定します。観察結果は末尾側を残す形で切り詰められ、最新のエントリが保持されます。バッファー済みの Reflection が保留中の場合、すでに Reflection 済みの行は、切り詰め処理の前に Reflection の要約へ自動的に置き換えられます。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: 2000→ デフォルト。最近の観察結果を約 2k トークン保持します。previousObserverTokens: 0→ 以前の観察結果を完全に省略します。previousObserverTokens: false→ 切り詰めを無効にし、以前の観察結果をすべて保持します。
既存スレッドの移行既存スレッドの移行への直接リンク
手動での移行は不要です。OM は既存のメッセージを読み取り、しきい値を超えたときに遅延して観察します。
- スレッドスコープ: スレッドが初めて
observation.messageTokensを超えたとき、Observer が未処理分を処理します。 - リソーススコープ: リソースに属するすべてのスレッドの未観察メッセージがまとめて処理されます。既存スレッドが多いユーザーの場合、かなりの時間がかかる可能性があります。
OM と他のメモリ機能の比較OM と他のメモリ機能の比較への直接リンク
- メッセージ履歴: 現在の会話を高い忠実度で記録します
- Working Memory: ユーザーの好み、名前、目標を保存する小さな構造化状態(JSON または Markdown)です
- Semantic Recall: 関連する過去のメッセージを RAG ベースで取得します
- マルチユーザースレッド: 複数のユーザーが 1 つのスレッドを共有する場合に、OM が個々のユーザーへ事実を関連付ける仕組みです
会話の要約や、時間とともに増える進行中の状態を Working Memory に保存している場合、OM の方が適しています。Working Memory は小さな構造化データに、OM は長期間のイベントログに使用します。OM はメッセージ履歴も自動的に管理し、観察処理が実行されるまでに残す生の履歴量は messageTokens 設定で制御します。
実用上、OM は Working Memory とメッセージ履歴の両方を置き換え、Semantic Recall より高い精度を低いコストで実現します。
関連項目関連項目への直接リンク
- Observational Memory リファレンス
- Memory の概要
- メッセージ履歴
- Memory Processor
- Mastra Code: Observational Memory を使用するコーディング Agent
- 📹 Mastra Processor と Observational Memory のワークショップ