Flux de contrôle
Les workflows exécutent une séquence de tâches prédéfinies, et vous pouvez contrôler la manière dont ce flux s’exécute. Les tâches sont divisées en étapes, qui peuvent être exécutées de différentes façons selon vos besoins. Elles peuvent s’exécuter séquentiellement ou en parallèle, ou suivre différents chemins en fonction de conditions.
Chaque étape est reliée à la suivante dans le workflow au moyen de schémas définis qui garantissent la maîtrise et la cohérence des données.
Principes fondamentauxLien direct vers Principes fondamentaux
- L’
inputSchemade la première étape doit correspondre à l’inputSchemadu workflow. - L’
outputSchemade la dernière étape doit correspondre à l’outputSchemadu workflow. - L’
outputSchemade chaque étape doit correspondre à l’inputSchemade l’étape suivante.- Si ce n’est pas le cas, utilisez le mappage des données d’entrée pour transformer les données dans la forme requise.
Enchaîner des étapes avec .then()Lien direct vers chaining-steps-with-then
Utilisez .then() pour exécuter les étapes dans l’ordre, afin que chacune puisse accéder au résultat de l’étape précédente.
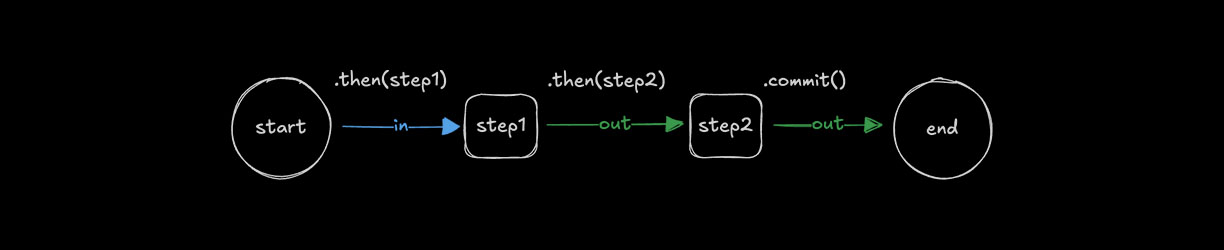
const step1 = createStep({
  inputSchema: z.object({
    message: z.string(),
  }),
  outputSchema: z.object({
    formatted: z.string(),
  }),
})

const step2 = createStep({
  inputSchema: z.object({
    formatted: z.string(),
  }),
  outputSchema: z.object({
    emphasized: z.string(),
  }),
})

export const testWorkflow = createWorkflow({
  inputSchema: z.object({
    message: z.string(),
  }),
  outputSchema: z.object({
    emphasized: z.string(),
  }),
})
  .then(step1)
  .then(step2)
  .commit()
Exécuter des étapes simultanément avec .parallel()Lien direct vers simultaneous-steps-with-parallel
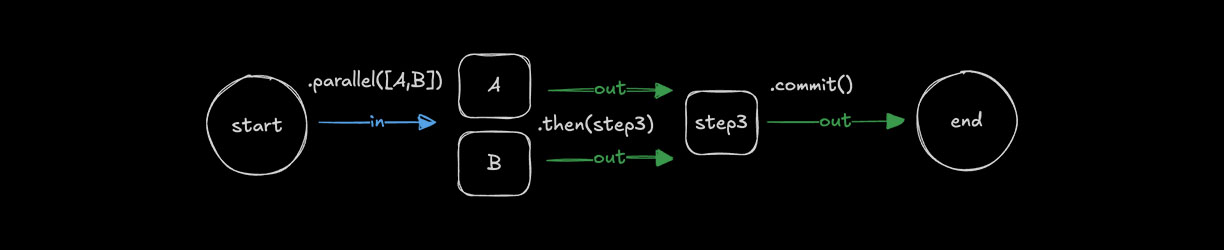
Utilisez .parallel() pour exécuter des étapes simultanément. Toutes les étapes parallèles doivent se terminer avant que le workflow ne passe à l’étape suivante. L’id de chaque étape sert à définir l’inputSchema d’une étape ultérieure et devient la clé de l’objet inputData utilisé pour accéder aux valeurs de l’étape précédente. Les sorties des étapes parallèles peuvent ensuite être référencées ou combinées par une étape ultérieure.
const step1 = createStep({
  id: 'step-1',
})

const step2 = createStep({
  id: 'step-2',
})

const step3 = createStep({
  id: 'step-3',
  inputSchema: z.object({
    'step-1': z.object({
      formatted: z.string(),
    }),
    'step-2': z.object({
      emphasized: z.string(),
    }),
  }),
  outputSchema: z.object({
    combined: z.string(),
  }),
  execute: async ({ inputData }) => {
    const { formatted } = inputData['step-1']
    const { emphasized } = inputData['step-2']
    return {
      combined: `${formatted} | ${emphasized}`,
    }
  },
})

export const testWorkflow = createWorkflow({
  inputSchema: z.object({
    message: z.string(),
  }),
  outputSchema: z.object({
    combined: z.string(),
  }),
})
  .parallel([step1, step2])
  .then(step3)
  .commit()
Structure de sortieLien direct vers Structure de sortie
Lorsque des étapes s’exécutent en parallèle, la sortie est un objet dont chaque clé correspond à l’id d’une étape et chaque valeur à la sortie de cette étape. Vous pouvez accéder indépendamment au résultat de chaque étape parallèle.
const step1 = createStep({
  id: 'format-step',
  inputSchema: z.object({ message: z.string() }),
  outputSchema: z.object({ formatted: z.string() }),
  execute: async ({ inputData }) => ({
    formatted: inputData.message.toUpperCase(),
  }),
})

const step2 = createStep({
  id: 'count-step',
  inputSchema: z.object({ message: z.string() }),
  outputSchema: z.object({ count: z.number() }),
  execute: async ({ inputData }) => ({
    count: inputData.message.length,
  }),
})

const step3 = createStep({
  id: 'combine-step',
  // The inputSchema must match the structure of parallel outputs
  inputSchema: z.object({
    'format-step': z.object({ formatted: z.string() }),
    'count-step': z.object({ count: z.number() }),
  }),
  outputSchema: z.object({ result: z.string() }),
  execute: async ({ inputData }) => {
    // Access each parallel step's output by its id
    const formatted = inputData['format-step'].formatted
    const count = inputData['count-step'].count
    return {
      result: `${formatted} (${count} characters)`,
    }
  },
})

export const testWorkflow = createWorkflow({
  id: 'parallel-output-example',
  inputSchema: z.object({ message: z.string() }),
  outputSchema: z.object({ result: z.string() }),
})
  .parallel([step1, step2])
  .then(step3)
  .commit()

// When executed with { message: "hello" }
// The parallel output structure will be:
// {
//   "format-step": { formatted: "HELLO" },
//   "count-step": { count: 5 }
// }
Points clés :
- La sortie de chaque étape parallèle est associée à son
id - Toutes les étapes parallèles s’exécutent simultanément
- L’étape suivante reçoit un objet contenant les sorties de toutes les étapes parallèles
- Vous devez définir l’
inputSchemade l’étape suivante de manière à correspondre à cette structure
Gérer les échecs des étapesLien direct vers Gérer les échecs des étapes
Si une étape parallèle lève une erreur, l’ensemble du bloc parallèle échoue. Pour créer des workflows parallèles résilients dans lesquels certaines étapes peuvent échouer, par exemple plusieurs agents de recherche dont l’un pourrait avoir un token d’authentification expiré, gérez les erreurs au sein de l’étape elle-même avec try/catch :
const resilientStep = createStep({
  id: 'researcher',
  inputSchema: z.object({ query: z.string() }),
  outputSchema: z.object({
    brief: z.string().nullable(),
    failed: z.boolean(),
  }),
  execute: async ({ inputData }) => {
    try {
      const result = await fetchExternalData(inputData.query)
      return { brief: result, failed: false }
    } catch {
      return { brief: null, failed: true }
    }
  },
})
De cette manière, l’étape réussit toujours avec un résultat typé, et l’étape en aval peut exclure les résultats ayant échoué :
const writerStep = createStep({
  id: 'writer',
  inputSchema: z.object({
    'researcher-a': z.object({ brief: z.string().nullable(), failed: z.boolean() }),
    'researcher-b': z.object({ brief: z.string().nullable(), failed: z.boolean() }),
  }),
  outputSchema: z.object({ synthesis: z.string() }),
  execute: async ({ inputData }) => {
    const briefs = Object.values(inputData)
      .filter(v => !v.failed && v.brief)
      .map(v => v.brief)
    return { synthesis: briefs.join('; ') }
  },
})
Consultez la section Choisir le bon modèle pour savoir quand utiliser .parallel() plutôt que .foreach().
Logique conditionnelle avec .branch()Lien direct vers conditional-logic-with-branch
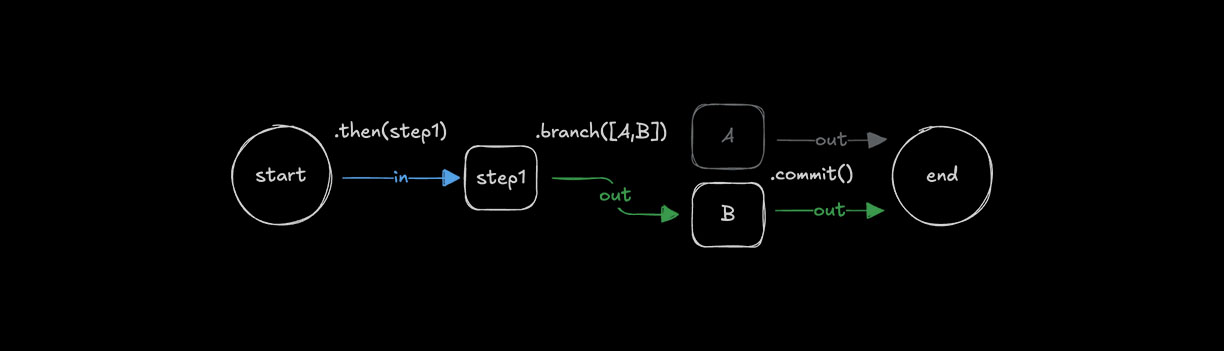
Utilisez .branch() pour choisir l’étape à exécuter selon une condition. Toutes les étapes d’une branche doivent avoir les mêmes inputSchema et outputSchema, car le branchement nécessite des schémas cohérents pour permettre aux workflows de suivre des chemins différents.
const step1 = createStep({...})

const stepA = createStep({
  inputSchema: z.object({
    value: z.number()
  }),
  outputSchema: z.object({
    result: z.string()
  })
});

const stepB = createStep({
  inputSchema: z.object({
    value: z.number()
  }),
  outputSchema: z.object({
    result: z.string()
  })
});

export const testWorkflow = createWorkflow({
  inputSchema: z.object({
    value: z.number()
  }),
  outputSchema: z.object({
    result: z.string()
  })
})
  .then(step1)
  .branch([
    [async ({ inputData: { value } }) => value > 10, stepA],
    [async ({ inputData: { value } }) => value <= 10, stepB]
  ])
  .commit();
Structure de sortieLien direct vers Structure de sortie
Lors d’un branchement conditionnel, une seule branche s’exécute, selon la première condition évaluée à true. La structure de sortie est similaire à celle de .parallel() : le résultat est associé à l’id de l’étape exécutée.
const step1 = createStep({
  id: 'initial-step',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ value: z.number() }),
  execute: async ({ inputData }) => inputData,
})

const highValueStep = createStep({
  id: 'high-value-step',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ result: z.string() }),
  execute: async ({ inputData }) => ({
    result: `High value: ${inputData.value}`,
  }),
})

const lowValueStep = createStep({
  id: 'low-value-step',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ result: z.string() }),
  execute: async ({ inputData }) => ({
    result: `Low value: ${inputData.value}`,
  }),
})

const finalStep = createStep({
  id: 'final-step',
  // The inputSchema must account for either branch's output
  inputSchema: z.object({
    'high-value-step': z.object({ result: z.string() }).optional(),
    'low-value-step': z.object({ result: z.string() }).optional(),
  }),
  outputSchema: z.object({ message: z.string() }),
  execute: async ({ inputData }) => {
    // Only one branch will have executed
    const result = inputData['high-value-step']?.result || inputData['low-value-step']?.result
    return { message: result }
  },
})

export const testWorkflow = createWorkflow({
  id: 'branch-output-example',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ message: z.string() }),
})
  .then(step1)
  .branch([
    [async ({ inputData }) => inputData.value > 10, highValueStep],
    [async ({ inputData }) => inputData.value <= 10, lowValueStep],
  ])
  .then(finalStep)
  .commit()

// When executed with { value: 15 }
// Only the high-value-step executes, output structure:
// {
//   "high-value-step": { result: "High value: 15" }
// }

// When executed with { value: 5 }
// Only the low-value-step executes, output structure:
// {
//   "low-value-step": { result: "Low value: 5" }
// }
Points clés :
- Une seule branche s’exécute, selon l’ordre d’évaluation des conditions
- La sortie est associée à l’
idde l’étape exécutée - Les étapes suivantes doivent prendre en charge toutes les sorties possibles des branches
- Utilisez des champs facultatifs dans l’
inputSchemalorsque l’étape suivante doit gérer plusieurs branches possibles - Les conditions sont évaluées dans l’ordre où elles sont définies
Mappage des données d’entréeLien direct vers Mappage des données d’entrée
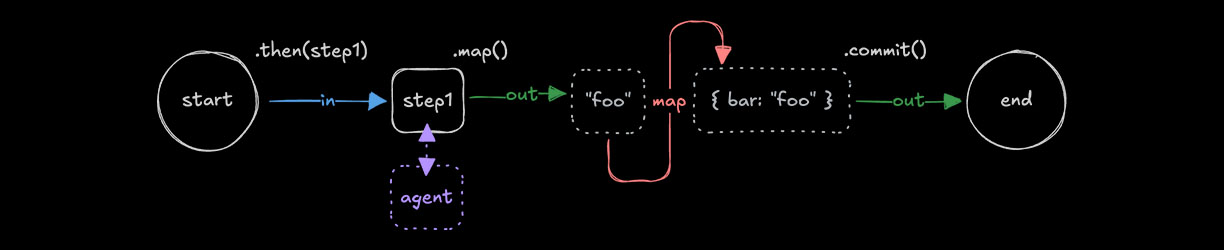
Lorsque vous utilisez .then(), .parallel() ou .branch(), il est parfois nécessaire de transformer la sortie d’une étape précédente pour qu’elle corresponde à l’entrée de la suivante. Dans ce cas, vous pouvez utiliser .map() pour accéder à inputData et le transformer afin de créer une structure de données adaptée à l’étape suivante.
const step1 = createStep({...});
const step2 = createStep({...});

export const testWorkflow = createWorkflow({...})
  .then(step1)
  .map(async ({ inputData }) => {
    const { foo } = inputData;
    return {
      bar: `new ${foo}`,
    };
  })
  .then(step2)
  .commit();
La méthode .map() fournit des fonctions utilitaires supplémentaires pour les scénarios de mappage plus complexes.
Fonctions utilitaires disponibles :
getStepResult(): accéder à la sortie complète d’une étape précisegetInitData<any>(): accéder aux données d’entrée initiales du workflowmapVariable(): utiliser une syntaxe objet déclarative pour extraire et renommer des champs
Sorties parallèles et conditionnellesLien direct vers Sorties parallèles et conditionnelles
Lorsque vous manipulez les sorties de .parallel() ou .branch(), vous pouvez utiliser .map() pour transformer la structure des données avant de la transmettre à l’étape suivante. Cette approche est particulièrement utile lorsque vous devez aplatir ou restructurer la sortie.
export const testWorkflow = createWorkflow({...})
  .parallel([step1, step2])
  .map(async ({ inputData }) => {
    // Transform the parallel output structure
    return {
      combined: `${inputData["step1"].value} - ${inputData["step2"].value}`
    };
  })
  .then(nextStep)
  .commit();
Vous pouvez également utiliser les fonctions utilitaires fournies par .map() :
export const testWorkflow = createWorkflow({...})
  .branch([
    [condition1, stepA],
    [condition2, stepB]
  ])
  .map(async ({ inputData, getStepResult }) => {
    // Access specific step results
    const stepAResult = getStepResult("stepA");
    const stepBResult = getStepResult("stepB");

    // Return the result from whichever branch executed
    return stepAResult || stepBResult;
  })
  .then(nextStep)
  .commit();
Répéter des étapesLien direct vers Répéter des étapes
Les workflows prennent en charge différentes méthodes de boucle qui permettent de répéter des étapes jusqu’à ce qu’une condition soit remplie, tant qu’elle reste remplie, ou d’itérer sur des tableaux. Les boucles peuvent être combinées avec d’autres méthodes de contrôle telles que .then().
Boucle avec .dountil()Lien direct vers looping-with-dountil
Utilisez .dountil() pour exécuter une étape de façon répétée jusqu’à ce qu’une condition devienne vraie.
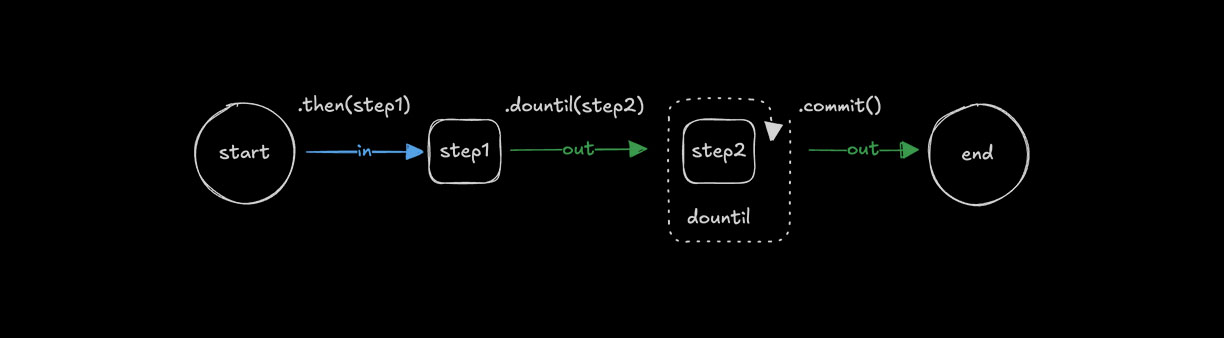
const step1 = createStep({...});

const step2 = createStep({
  execute: async ({ inputData }) => {
    const { number } = inputData;
    return {
      number: number + 1
    };
  }
});

export const testWorkflow = createWorkflow({})
  .then(step1)
  .dountil(step2, async ({ inputData: { number } }) => number > 10)
  .commit();
Boucle avec .dowhile()Lien direct vers looping-with-dowhile
Utilisez .dowhile() pour exécuter une étape de façon répétée tant qu’une condition reste vraie.
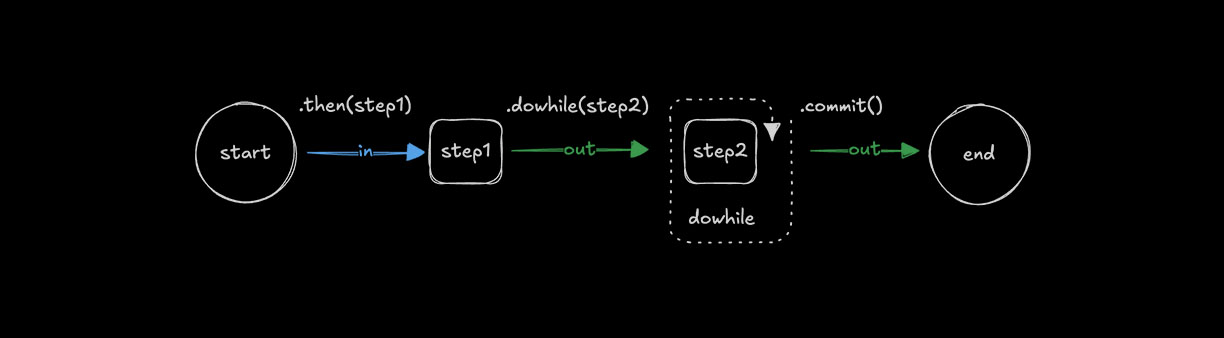
const step1 = createStep({...});

const step2 = createStep({
  execute: async ({ inputData }) => {
    const { number } = inputData;
    return {
      number: number + 1
    };
  }
});

export const testWorkflow = createWorkflow({})
  .then(step1)
  .dowhile(step2, async ({ inputData: { number } }) => number < 10)
  .commit();
Boucle avec .foreach()Lien direct vers looping-with-foreach
Utilisez .foreach() pour exécuter la même étape sur chaque élément d’un tableau. L’entrée doit être de type array afin que la boucle puisse parcourir ses valeurs et appliquer à chacune la logique de l’étape. Consultez la section Choisir le bon modèle pour savoir quand utiliser .foreach() plutôt que d’autres méthodes.
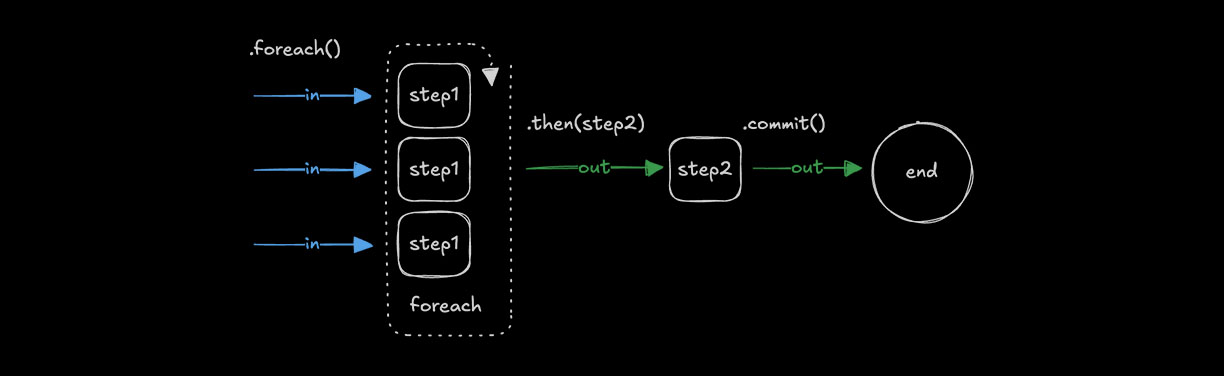
const step1 = createStep({
  inputSchema: z.string(),
  outputSchema: z.string(),
  execute: async ({ inputData }) => {
    return inputData.toUpperCase();
  }
});

const step2 = createStep({...});

export const testWorkflow = createWorkflow({
  inputSchema: z.array(z.string()),
  outputSchema: z.array(z.string())
})
  .foreach(step1)
  .then(step2)
  .commit();
Structure de sortieLien direct vers Structure de sortie
La méthode .foreach() renvoie toujours un tableau contenant la sortie de chaque itération. L’ordre des sorties correspond à celui des entrées.
const addTenStep = createStep({
  id: 'add-ten',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ value: z.number() }),
  execute: async ({ inputData }) => ({
    value: inputData.value + 10,
  }),
})

export const testWorkflow = createWorkflow({
  id: 'foreach-output-example',
  inputSchema: z.array(z.object({ value: z.number() })),
  outputSchema: z.array(z.object({ value: z.number() })),
})
  .foreach(addTenStep)
  .commit()

// When executed with [{ value: 1 }, { value: 22 }, { value: 333 }]
// Output: [{ value: 11 }, { value: 32 }, { value: 343 }]
Limites de concurrenceLien direct vers Limites de concurrence
Utilisez concurrency pour contrôler le nombre d’éléments du tableau traités. La valeur par défaut est 1, ce qui exécute les étapes séquentiellement. Une valeur plus élevée permet à .foreach() de traiter plusieurs éléments simultanément.
const step1 = createStep({...})

export const testWorkflow = createWorkflow({...})
  .foreach(step1, { concurrency: 4 })
  .commit();
Agréger les résultats après .foreach()Lien direct vers aggregating-results-after-foreach
Puisque .foreach() renvoie un tableau, vous pouvez utiliser .then() ou .map() pour agréger ou transformer les résultats. L’étape qui suit .foreach() reçoit le tableau entier comme entrée.
const processItemStep = createStep({
  id: 'process-item',
  inputSchema: z.object({ value: z.number() }),
  outputSchema: z.object({ processed: z.number() }),
  execute: async ({ inputData }) => ({
    processed: inputData.value * 2,
  }),
})

const aggregateStep = createStep({
  id: 'aggregate',
  // Input is an array of outputs from foreach
  inputSchema: z.array(z.object({ processed: z.number() })),
  outputSchema: z.object({ total: z.number() }),
  execute: async ({ inputData }) => ({
    // Sum all processed values
    total: inputData.reduce((sum, item) => sum + item.processed, 0),
  }),
})

export const testWorkflow = createWorkflow({
  id: 'foreach-aggregate-example',
  inputSchema: z.array(z.object({ value: z.number() })),
  outputSchema: z.object({ total: z.number() }),
})
  .foreach(processItemStep)
  .then(aggregateStep) // Receives the full array from foreach
  .commit()

// When executed with [{ value: 1 }, { value: 2 }, { value: 3 }]
// After foreach: [{ processed: 2 }, { processed: 4 }, { processed: 6 }]
// After aggregate: { total: 12 }
Vous pouvez également utiliser .map() pour transformer le tableau obtenu :
export const testWorkflow = createWorkflow({...})
  .foreach(processItemStep)
  .map(async ({ inputData }) => ({
    // Transform the array into a different structure
    values: inputData.map(item => item.processed),
    count: inputData.length
  }))
  .then(nextStep)
  .commit();
Enchaîner plusieurs appels à .foreach()Lien direct vers chaining-multiple-foreach-calls
Lorsque vous enchaînez des appels à .foreach(), chacun opère sur le tableau produit par l’étape précédente. Cette approche est utile lorsque chaque élément de votre tableau doit être transformé successivement par plusieurs étapes.
const chunkStep = createStep({
  id: 'chunk',
  // Takes a document, returns an array of chunks
  inputSchema: z.object({ content: z.string() }),
  outputSchema: z.array(z.object({ chunk: z.string() })),
  execute: async ({ inputData }) => {
    // Split document into chunks
    const chunks = inputData.content.match(/.{1,100}/g) || []
    return chunks.map(chunk => ({ chunk }))
  },
})

const embedStep = createStep({
  id: 'embed',
  // Takes a single chunk, returns embedding
  inputSchema: z.object({ chunk: z.string() }),
  outputSchema: z.object({ embedding: z.array(z.number()) }),
  execute: async ({ inputData }) => ({
    embedding: [/* vector embedding */],
  }),
})

// For a single document that produces multiple chunks:
export const singleDocWorkflow = createWorkflow({
  id: 'single-doc-rag',
  inputSchema: z.object({ content: z.string() }),
  outputSchema: z.array(z.object({ embedding: z.array(z.number()) })),
})
  .then(chunkStep) // Returns array of chunks
  .foreach(embedStep) // Process each chunk -> array of embeddings
  .commit()
Pour traiter plusieurs documents qui produisent chacun plusieurs fragments, plusieurs options s’offrent à vous :
Option 1 : traiter tous les documents dans une seule étape avec contrôle des lots
const downloadAndChunkStep = createStep({
  id: "download-and-chunk",
  inputSchema: z.array(z.string()),  // Array of URLs
  outputSchema: z.array(z.object({ chunk: z.string(), source: z.string() })),
  execute: async ({ inputData: urls }) => {
    // Control batching/parallelization within the step
    const allChunks = [];
    for (const url of urls) {
      const content = await fetch(url).then(r => r.text());
      const chunks = content.match(/.{1,100}/g) || [];
      allChunks.push(...chunks.map(chunk => ({ chunk, source: url })));
    }
    return allChunks;
  }
});

export const multiDocWorkflow = createWorkflow({...})
  .then(downloadAndChunkStep)  // Returns flat array of all chunks
  .foreach(embedStep, { concurrency: 10 })  // Embed each chunk in parallel
  .commit();
Option 2 : utiliser foreach pour les documents et agréger les fragments, puis un autre foreach pour les embeddings
const downloadStep = createStep({
  id: 'download',
  inputSchema: z.string(), // Single URL
  outputSchema: z.object({ content: z.string(), source: z.string() }),
  execute: async ({ inputData: url }) => ({
    content: await fetch(url).then(r => r.text()),
    source: url,
  }),
})

const chunkDocStep = createStep({
  id: 'chunk-doc',
  inputSchema: z.object({ content: z.string(), source: z.string() }),
  outputSchema: z.array(z.object({ chunk: z.string(), source: z.string() })),
  execute: async ({ inputData }) => {
    const chunks = inputData.content.match(/.{1,100}/g) || []
    return chunks.map(chunk => ({ chunk, source: inputData.source }))
  },
})

export const multiDocWorkflow = createWorkflow({
  id: 'multi-doc-rag',
  inputSchema: z.array(z.string()), // Array of URLs
  outputSchema: z.array(z.object({ embedding: z.array(z.number()) })),
})
  .foreach(downloadStep, { concurrency: 5 }) // Download docs in parallel
  .foreach(chunkDocStep) // Chunk each doc -> array of chunk arrays
  .map(async ({ inputData }) => {
    // Flatten nested arrays: [[chunks], [chunks]] -> [chunks]
    return inputData.flat()
  })
  .foreach(embedStep, { concurrency: 10 }) // Embed all chunks
  .commit()
Points clés sur l’enchaînement de .foreach() :
- Chaque
.foreach()opère sur le tableau de l’étape précédente - Si une étape au sein de
.foreach()renvoie un tableau, la sortie devient un tableau de tableaux - Utilisez
.map()avec.flat()pour aplatir les tableaux imbriqués lorsque nécessaire - Pour les pipelines RAG complexes, l’option 1, qui gère les lots dans une seule étape, offre souvent un meilleur contrôle
Workflows imbriqués dans une boucle foreachLien direct vers Workflows imbriqués dans une boucle foreach
L’étape qui suit .foreach() ne s’exécute qu’une fois toutes les itérations terminées. Si vous devez exécuter plusieurs opérations séquentielles par élément, utilisez un workflow imbriqué au lieu d’enchaîner plusieurs appels à .foreach(). Toutes les opérations propres à un élément restent ainsi regroupées et le flux de données est plus clair.
// Define a workflow that processes a single document
const processDocumentWorkflow = createWorkflow({
  id: 'process-document',
  inputSchema: z.object({ url: z.string() }),
  outputSchema: z.object({
    embeddings: z.array(z.array(z.number())),
    metadata: z.object({ url: z.string(), chunkCount: z.number() }),
  }),
})
  .then(downloadStep) // Download the document
  .then(chunkStep) // Split into chunks
  .then(embedChunksStep) // Embed all chunks for this document
  .then(formatResultStep) // Format the final output
  .commit()

// Use the nested workflow inside foreach
export const batchProcessWorkflow = createWorkflow({
  id: 'batch-process-documents',
  inputSchema: z.array(z.object({ url: z.string() })),
  outputSchema: z.array(
    z.object({
      embeddings: z.array(z.array(z.number())),
      metadata: z.object({ url: z.string(), chunkCount: z.number() }),
    }),
  ),
})
  .foreach(processDocumentWorkflow, { concurrency: 3 })
  .commit()

// Each document goes through all 4 steps before the next document starts (with concurrency: 1)
// With concurrency: 3, up to 3 documents process their full pipelines in parallel
Pourquoi utiliser des workflows imbriqués :
- Meilleur parallélisme : avec
concurrency: N, plusieurs éléments exécutent simultanément leur pipeline complet. Un enchaînement.foreach().foreach()fait passer tous les éléments par l’étape 1, attend, puis les fait tous passer par l’étape 2 ; les workflows imbriqués permettent à chaque élément de progresser indépendamment - Toutes les étapes d’un élément se terminent ensemble avant la collecte des résultats
- Une solution plus claire que plusieurs appels à
.foreach(), qui créent des tableaux imbriqués - Chaque exécution de workflow imbriqué est indépendante et dispose de son propre flux de données
- La logique propre à chaque élément est plus facile à tester séparément et à réutiliser
Fonctionnement :
- Le workflow parent transmet chaque élément du tableau à une instance du workflow imbriqué
- Chaque workflow imbriqué exécute la séquence complète de ses étapes pour cet élément
- Avec
concurrency > 1, plusieurs workflows imbriqués s’exécutent en parallèle - La sortie finale du workflow imbriqué devient un élément du tableau de résultats
- Une fois tous les workflows imbriqués terminés, l’étape suivante du workflow parent reçoit le tableau complet
Choisir le bon modèleLien direct vers Choisir le bon modèle
Utilisez cette section comme référence pour sélectionner la méthode de flux de contrôle appropriée.
Référence rapideLien direct vers Référence rapide
| Méthode | Objectif | Entrée | Sortie | Concurrence |
|---|---|---|---|---|
.then(step) | Traitement séquentiel | T | U | S. O. (un à la fois) |
.parallel([a, b]) | Opérations différentes sur une même entrée | T | { a: U, b: V } | Toutes s’exécutent simultanément |
.foreach(step) | Même opération sur chaque élément du tableau | T[] | U[] | Configurable (valeur par défaut : 1) |
.branch([...]) | Sélection conditionnelle d’un chemin | T | { selectedStep: U } | Une seule branche s’exécute |
.parallel() ou .foreach()Lien direct vers parallel-vs-foreach
Utilisez .parallel() lorsqu’une entrée unique nécessite plusieurs traitements différents :
// Same user data processed differently in parallel
workflow.parallel([validateStep, enrichStep, scoreStep]).then(combineResultsStep)
Utilisez .foreach() lorsque plusieurs entrées nécessitent le même traitement :
// Multiple URLs each processed the same way
workflow.foreach(downloadStep, { concurrency: 5 }).then(aggregateStep)
Quand utiliser des workflows imbriquésLien direct vers Quand utiliser des workflows imbriqués
Dans .foreach() — lorsque chaque élément du tableau nécessite plusieurs étapes séquentielles :
// Each document goes through a full pipeline
const processDocWorkflow = createWorkflow({...})
  .then(downloadStep)
  .then(parseStep)
  .then(embedStep)
  .commit();

workflow.foreach(processDocWorkflow, { concurrency: 3 })
Un seul appel à .foreach() conserve une structure de résultats plate. Enchaîner .foreach().foreach() crée des tableaux imbriqués.
Dans .parallel() — lorsqu’une branche parallèle nécessite son propre pipeline en plusieurs étapes :
const pipelineA = createWorkflow({...}).then(step1).then(step2).commit();
const pipelineB = createWorkflow({...}).then(step3).then(step4).commit();

workflow.parallel([pipelineA, pipelineB])
Modèles d’enchaînementLien direct vers Modèles d’enchaînement
| Modèle | Résultat | Cas d’utilisation courant |
|---|---|---|
.then().then() | Étapes séquentielles | Pipelines simples |
.parallel().then() | Exécution parallèle, puis combinaison | Dispersion et regroupement |
.foreach().then() | Traitement de tous les éléments, puis agrégation | MapReduce |
.foreach().foreach() | Création d’un tableau de tableaux | À éviter : utilisez un workflow imbriqué ou .map() avec .flat() |
.foreach(workflow) | Pipeline complet pour chaque élément | Traitement en plusieurs étapes de chaque élément du tableau |
Synchronisation : quand l’étape suivante s’exécute-t-elle ?Lien direct vers Synchronisation : quand l’étape suivante s’exécute-t-elle ?
.parallel() et .foreach() constituent tous deux des points de synchronisation. L’étape suivante du workflow ne s’exécute qu’une fois toutes les branches parallèles ou toutes les itérations du tableau terminées.
workflow
  .parallel([stepA, stepB, stepC]) // All 3 run simultaneously
  .then(combineStep) // Waits for ALL 3 to finish before running
  .commit()

workflow
  .foreach(processStep, { concurrency: 5 }) // Up to 5 items process at once
  .then(aggregateStep) // Waits for ALL items to finish before running
  .commit()
Cela signifie que :
.parallel()collecte les sorties de toutes les branches dans un objet, puis le transmet à l’étape suivante.foreach()collecte les sorties de toutes les itérations dans un tableau, puis le transmet à l’étape suivante- Les résultats ne peuvent pas être « diffusés » à l’étape suivante au fur et à mesure de leur production
Comportement de la concurrenceLien direct vers Comportement de la concurrence
| Méthode | Comportement |
|---|---|
.then() | Séquentiel : une étape à la fois |
.parallel() | Toutes les branches s’exécutent simultanément (aucune option de limite) |
.foreach() | Contrôlé par { concurrency: N } ; la valeur par défaut est 1 (séquentiel) |
Workflow imbriqué dans .foreach() | Respecte le paramètre de concurrence du parent |
Conseil de performance : pour les opérations limitées par les entrées-sorties dans .foreach(), augmentez la concurrence afin de traiter des éléments en parallèle :
// Process up to 10 items simultaneously
workflow.foreach(fetchDataStep, { concurrency: 10 })
Gestion des bouclesLien direct vers Gestion des boucles
Les conditions de boucle peuvent être mises en œuvre de différentes façons selon la manière dont vous souhaitez terminer la boucle.
Les modèles courants vérifient les valeurs renvoyées dans inputData et définissent un nombre maximal d’itérations. Ils peuvent également interrompre l’exécution lorsqu’une limite est atteinte.
Interrompre les bouclesLien direct vers Interrompre les boucles
Utilisez iterationCount pour limiter le nombre d’exécutions d’une boucle. Si ce nombre dépasse votre seuil, levez une erreur pour faire échouer l’étape et arrêter le workflow.
const step1 = createStep({...});

export const testWorkflow = createWorkflow({...})
  .dountil(step1, async ({ inputData: { userResponse, iterationCount } }) => {
    if (iterationCount >= 10) {
      throw new Error("Maximum iterations reached");
    }
    return userResponse === "yes";
  })
  .commit();