Rappel sémantique
Si vous demandez à un ami ce qu'il a fait le week-end dernier, il recherchera dans sa mémoire les événements associés au « week-end dernier », puis vous racontera ce qu'il a fait. Le rappel sémantique de Mastra fonctionne de manière assez similaire.
Regardez Le rappel sémantique dans Mastra pour découvrir comment les Agents retrouvent les messages pertinents de conversations antérieures.
Fonctionnement du rappel sémantiqueLien direct vers Fonctionnement du rappel sémantique
Le rappel sémantique est une recherche fondée sur le RAG qui aide les Agents à conserver le contexte lors d'interactions prolongées, lorsque les messages ne figurent plus dans l'historique récent des messages.
Il utilise les embeddings vectoriels des messages pour effectuer une recherche par similarité, s'intègre aux stockages vectoriels et propose des fenêtres de contexte configurables autour des messages retrouvés.
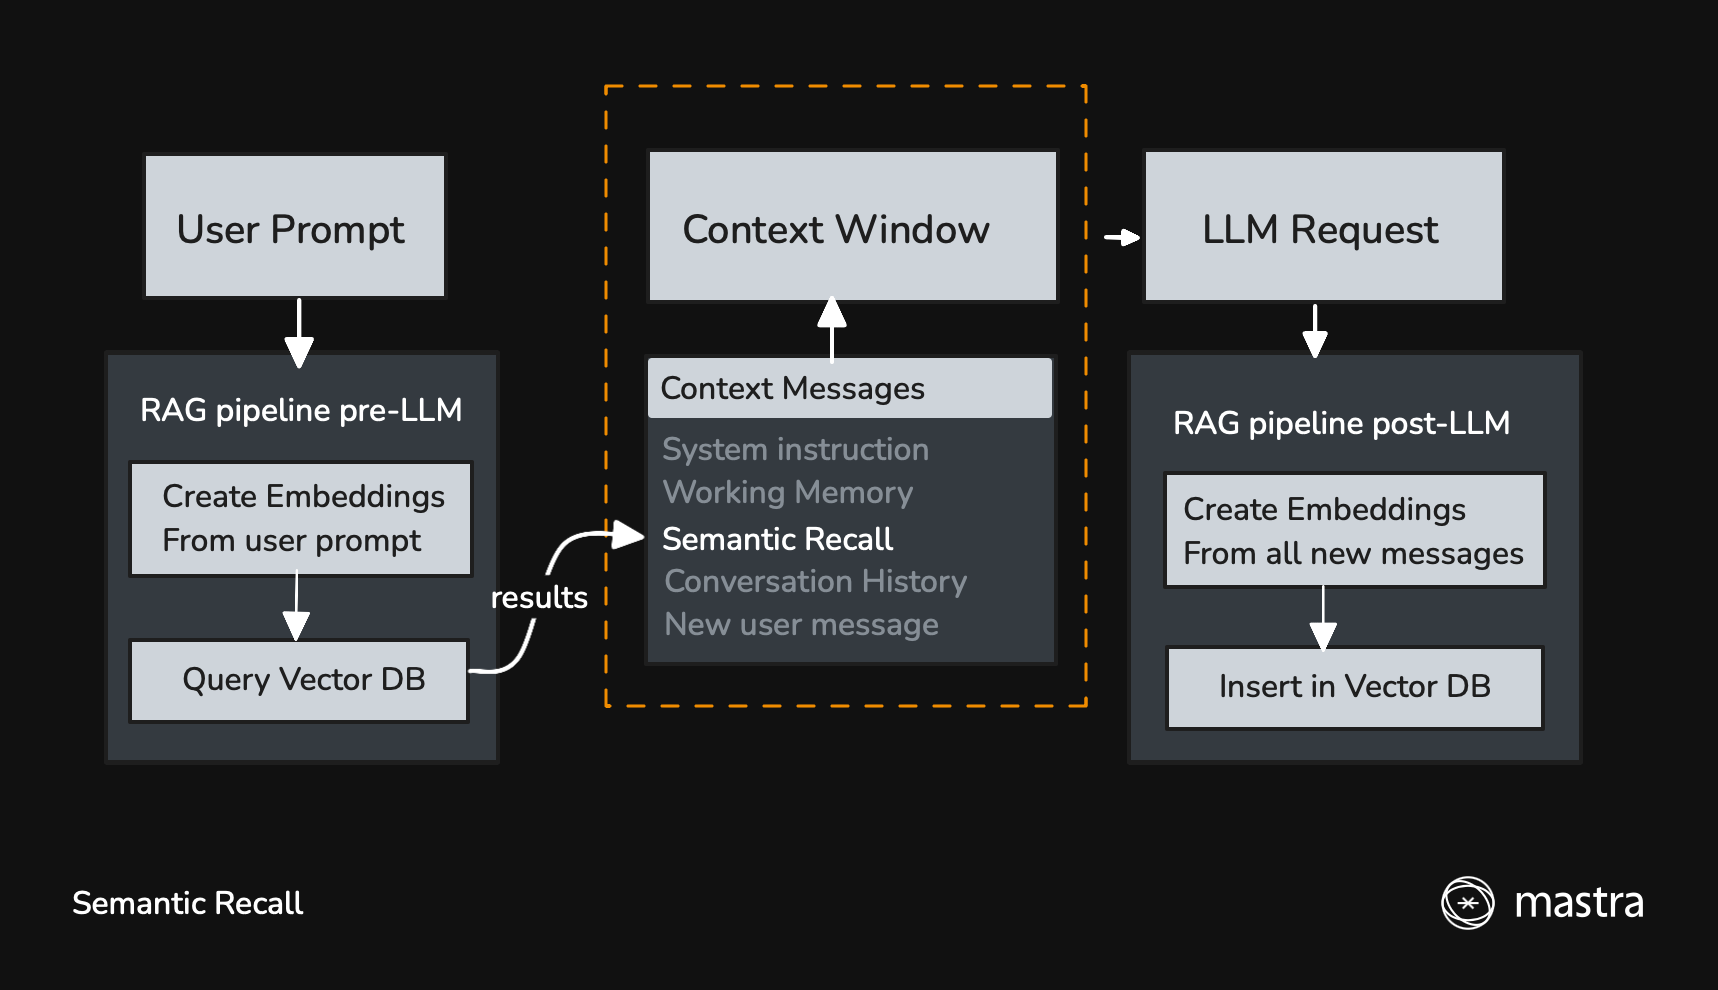
Lorsqu'il est activé, les nouveaux messages servent à interroger une base de données vectorielle afin de retrouver des messages sémantiquement similaires.
Après réception d'une réponse du LLM, tous les nouveaux messages (utilisateur, assistant, appels de Tools et leurs résultats) sont insérés dans la base de données vectorielle afin de pouvoir être rappelés lors d'interactions ultérieures.
Démarrage rapideLien direct vers Démarrage rapide
Le rappel sémantique est désactivé par défaut. Pour l'activer, définissez semanticRecall: true dans options et fournissez un stockage vector ainsi qu'un embedder :
- LibSQL
- MongoDB
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { MongoDBStore, MongoDBVector } from '@mastra/mongodb'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'support-agent',
  name: 'SupportAgent',
  instructions: 'You are a helpful support agent.',
  model: 'openai/gpt-5.6-sol',
  memory: new Memory({
    storage: new MongoDBStore({
      id: 'agent-storage',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    vector: new MongoDBVector({
      id: 'agent-vector',
      uri: process.env.MONGODB_URI,
      dbName: process.env.MONGODB_DB_NAME,
    }),
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
Utiliser la méthode recall()Lien direct vers using-the-recall-method
Alors que listMessages récupère les messages par ID de fil avec une pagination simple, recall() ajoute la prise en charge de la recherche sémantique. Lorsque vous devez retrouver des messages selon leur sens plutôt que leur ancienneté, utilisez recall() avec un vectorSearchString :
const memory = await agent.getMemory()

// Basic recall - similar to listMessages
const { messages } = await memory!.recall({
  threadId: 'thread-123',
  perPage: 50,
})

// Semantic recall - find messages by meaning
const { messages: relevantMessages } = await memory!.recall({
  threadId: 'thread-123',
  vectorSearchString: 'What did we discuss about the project deadline?',
  threadConfig: {
    semanticRecall: true,
  },
})
Configuration du stockageLien direct vers Configuration du stockage
Le rappel sémantique s'appuie sur un stockage et une base de données vectorielle pour conserver les messages et leurs embeddings.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { LibSQLStore, LibSQLVector } from '@mastra/libsql'

const agent = new Agent({
  memory: new Memory({
    // this is the default storage db if omitted
    storage: new LibSQLStore({
      id: 'agent-storage',
      url: 'file:./local.db',
    }),
    // this is the default vector db if omitted
    vector: new LibSQLVector({
      id: 'agent-vector',
      url: 'file:./local.db',
    }),
    options: {
      semanticRecall: true,
    },
  }),
})
Chaque page de stockage vectoriel ci-dessous comprend des instructions d'installation, des paramètres de configuration et des exemples d'utilisation :
- Astra
- Chroma
- Cloudflare Vectorize
- Convex
- Couchbase
- DuckDB
- Elasticsearch
- LanceDB
- libSQL
- MongoDB
- OpenSearch
- OracleDB
- Pinecone
- PostgreSQL
- Qdrant
- S3 Vectors
- Turbopuffer
- Upstash
Configuration du rappelLien direct vers Configuration du rappel
Les options suivantes contrôlent le comportement du rappel sémantique :
- topK : nombre de messages similaires à récupérer
- messageRange : messages environnants à inclure avec chaque correspondance
- scope : recherche dans le fil actuel ou dans tous les fils d'une ressource
- filter : critères de métadonnées qui limitent les résultats de recherche
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        topK: 3, // Retrieve 3 similar messages
        messageRange: 2, // Include 2 messages before and after each match
        scope: 'resource', // Search all threads for this resource
        filter: { projectId: { $eq: 'project-a' } },
      },
    },
  }),
})
scope: 'resource' est pris en charge par les adaptateurs de stockage LibSQL, OracleDB, PostgreSQL, MongoDB et Upstash.
Filtrage par métadonnéesLien direct vers Filtrage par métadonnées
L'option filter limite les résultats du rappel sémantique aux messages dont les métadonnées de fil correspondent.
const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    options: {
      semanticRecall: {
        scope: 'resource',
        filter: {
          projectId: { $eq: 'project-a' },
          category: { $in: ['work', 'personal'] },
        },
      },
    },
  }),
})
Les filtres s'appliquent aux métadonnées stockées dans les embeddings des messages au moment de leur enregistrement. Si les métadonnées du fil changent ensuite, les embeddings existants conservent leurs anciennes métadonnées jusqu'à ce que ces messages soient enregistrés ou indexés de nouveau.
Opérateurs de filtre pris en charge :
$and: ET logique$eq: égal à$gt: supérieur à$gte: supérieur ou égal à$in: présent dans le tableau$lt: inférieur à$lte: inférieur ou égal à$ne: différent de$nin: absent du tableau$or: OU logique
L'exemple suivant illustre les filtres de métadonnées pour des cas d'utilisation courants :
// Filter by project
const options = {
  semanticRecall: { filter: { projectId: { $eq: 'my-project' } } },
}

// Filter by multiple categories
const options = {
  semanticRecall: { filter: { category: { $in: ['work', 'research'] } } },
}

// Filter by project and priority
const options = {
  semanticRecall: {
    filter: {
      $and: [{ projectId: { $eq: 'project-a' } }, { priority: { $gte: 3 } }],
    },
  },
}
Configuration de l'embedderLien direct vers Configuration de l'embedder
Le rappel sémantique s'appuie sur un modèle d'embedding pour convertir les messages en embeddings. Mastra prend en charge les modèles d'embedding au moyen du routeur de modèles et de chaînes provider/model. Vous pouvez également utiliser n'importe quel modèle d'embedding compatible avec l'AI SDK.
Utiliser le Model Router (recommandé)Lien direct vers Utiliser le Model Router (recommandé)
La méthode la plus simple consiste à utiliser une chaîne provider/model avec prise en charge de l'autocomplétion :
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
    options: {
      semanticRecall: true,
    },
  }),
})
Modèles d'embedding pris en charge :
- OpenAI:
text-embedding-3-small,text-embedding-3-large,text-embedding-ada-002 - Google:
gemini-embedding-001 - OpenRouter : accès aux modèles d'embedding de différents Providers
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel({
      providerId: 'openrouter',
      modelId: 'openai/text-embedding-3-small',
    }),
  }),
})
Le routeur de modèles détecte automatiquement les clés d'API dans les variables d'environnement (OPENAI_API_KEY, GOOGLE_API_KEY, OPENROUTER_API_KEY). Les modèles Google se rabattent également sur GOOGLE_GENERATIVE_AI_API_KEY.
Utiliser les packages de l'AI SDKLien direct vers Utiliser les packages de l'AI SDK
Vous pouvez également utiliser directement les modèles d'embedding de l'AI SDK :
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { ModelRouterEmbeddingModel } from '@mastra/core/llm'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: new ModelRouterEmbeddingModel('openai/text-embedding-3-small'),
  }),
})
Utiliser FastEmbed (local)Lien direct vers Utiliser FastEmbed (local)
Pour utiliser FastEmbed (un modèle d'embedding local), installez @mastra/fastembed :
- npm
- pnpm
- Yarn
- Bun
npm install @mastra/fastembed@latest
pnpm add @mastra/fastembed@latest
yarn add @mastra/fastembed@latest
bun add @mastra/fastembed@latest
Configurez-le ensuite dans votre mémoire :
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'
import { fastembed } from '@mastra/fastembed'

const agent = new Agent({
  id: 'agent',
  memory: new Memory({
    embedder: fastembed,
  }),
})
Optimisation de l'index PostgreSQLLien direct vers Optimisation de l'index PostgreSQL
Lorsque vous utilisez PostgreSQL comme stockage vectoriel, vous pouvez optimiser les performances du rappel sémantique en configurant l'index vectoriel. Cette optimisation est particulièrement importante pour les déploiements à grande échelle qui contiennent des milliers de messages.
PostgreSQL prend en charge les index IVFFlat et HNSW. Par défaut, Mastra crée un index IVFFlat, mais les index HNSW offrent généralement de meilleures performances, en particulier avec les embeddings OpenAI qui utilisent la distance par produit scalaire.
import { Memory } from '@mastra/memory'
import { PgStore, PgVector } from '@mastra/pg'

const agent = new Agent({
  memory: new Memory({
    storage: new PgStore({
      id: 'agent-storage',
      connectionString: process.env.DATABASE_URL,
    }),
    vector: new PgVector({
      id: 'agent-vector',
      connectionString: process.env.DATABASE_URL,
    }),
    options: {
      semanticRecall: {
        topK: 5,
        messageRange: 2,
        indexConfig: {
          type: 'hnsw', // Use HNSW for better performance
          metric: 'dotproduct', // Best for OpenAI embeddings
          m: 16, // Number of bi-directional links (default: 16)
          efConstruction: 64, // Size of candidate list during construction (default: 64)
        },
      },
    },
  }),
})
Pour obtenir des informations détaillées sur les options de configuration de l'index et l'optimisation des performances, consultez le guide de configuration de PgVector.
Désactiver le rappel sémantiqueLien direct vers Désactiver le rappel sémantique
Le rappel sémantique est désactivé par défaut (semanticRecall: false). Chaque appel ajoute de la latence, car les nouveaux messages sont convertis en embeddings et servent à interroger une base de données vectorielle avant d'être transmis au LLM.
Laissez le rappel sémantique désactivé dans les cas suivants :
- L'historique des messages fournit suffisamment de contexte pour la conversation en cours.
- Vous développez des applications sensibles aux performances, comme l'audio bidirectionnel en temps réel, dans lesquelles la latence des embeddings et des requêtes vectorielles est perceptible.
Consulter les messages rappelésLien direct vers Consulter les messages rappelés
Lorsque le traçage est activé, tous les messages retrouvés au moyen du rappel sémantique apparaissent dans la sortie de Trace de l'Agent, avec l'historique récent des messages s'il est configuré.