Memory
Memory permet à votre agent de mémoriser les messages des utilisateurs, les réponses de l’agent et les résultats des outils au fil des interactions. Il dispose ainsi du contexte nécessaire pour rester cohérent, assurer la continuité de la conversation et produire de meilleures réponses au fil du temps.
Les agents Mastra peuvent être configurés pour stocker l’historique des messages. Vous pouvez également activer les fonctionnalités suivantes :
- Observational Memory (recommandé) : utilise des agents en arrière-plan pour tenir un journal d’observations dense, qui remplace l’historique brut des messages à mesure qu’il s’allonge. La fenêtre de contexte reste ainsi réduite, sans perdre la mémoire à long terme.
- Mémoire de travail : stocke de façon persistante des données utilisateur structurées, telles que les noms, les préférences et les objectifs.
- Rappel sémantique : retrouve les anciens messages pertinents d’après leur sens plutôt que par correspondance exacte de mots-clés.
- Threads multi-utilisateurs : permet à plusieurs utilisateurs de partager un même thread.
Si l’ensemble de la mémoire dépasse la limite de contexte du modèle, les processeurs de mémoire peuvent filtrer, réduire ou hiérarchiser le contenu afin de préserver les informations les plus pertinentes.
Les résultats de Memory sont stockés auprès d’un ou de plusieurs fournisseurs de stockage configurés.
Regardez la vidéo Concepts de Memory dans Mastra pour découvrir les différentes couches de mémoire que les agents peuvent utiliser.
Quand utiliser MemoryLien direct vers Quand utiliser Memory
Utilisez Memory lorsque votre agent doit mener des conversations en plusieurs échanges qui font référence à des interactions précédentes, se souvenir des préférences de l’utilisateur ou de faits mentionnés plus tôt dans une session, ou encore enrichir progressivement le contexte d’un thread de conversation. Memory est inutile pour les requêtes en un seul échange, où chaque interaction est indépendante.
Démarrage rapideLien direct vers Démarrage rapide
Installez le package
@mastra/memory.- npm
- pnpm
- Yarn
- Bun
npm install @mastra/memory@latestpnpm add @mastra/memory@latestyarn add @mastra/memory@latestbun add @mastra/memory@latestMemory nécessite un fournisseur de stockage pour conserver l’historique des messages, y compris les messages des utilisateurs et les réponses de l’agent.
Pour ce démarrage rapide, utilisez
@mastra/libsql.- npm
- pnpm
- Yarn
- Bun
npm install @mastra/libsql@latestpnpm add @mastra/libsql@latestyarn add @mastra/libsql@latestbun add @mastra/libsql@latestPour en savoir plus sur les fournisseurs disponibles et le fonctionnement du stockage dans Mastra, consultez la documentation sur le stockage.
Ajoutez le fournisseur de stockage à votre instance Mastra principale afin d’activer Memory pour tous les agents configurés.
src/mastra/index.tsimport { Mastra } from '@mastra/core'import { LibSQLStore } from '@mastra/libsql'export const mastra = new Mastra({storage: new LibSQLStore({id: 'mastra-storage',url: ':memory:',}),})Créez une instance de
Memoryet transmettez-la à l’optionmemoryde l’agent.src/mastra/agents/memory-agent.tsimport { Agent } from '@mastra/core/agent'import { Memory } from '@mastra/memory'export const memoryAgent = new Agent({id: 'memory-agent',name: 'Memory Agent',memory: new Memory({options: {lastMessages: 20,},}),})Consultez la classe Memory pour obtenir la liste complète des options de configuration.
Appelez votre agent, par exemple dans Studio. Dans Studio, démarrez une nouvelle discussion avec votre agent, puis regardez la barre latérale droite. Elle affiche désormais diverses informations relatives à Memory.
Historique des messagesLien direct vers Historique des messages
Transmettez un objet memory contenant resource et thread pour suivre l’historique des messages.
resource: identifiant stable de l’utilisateur ou de l’entité.thread: ID qui isole une conversation ou une session donnée.
const response = await memoryAgent.generate('Remember my favorite color is blue.', {
  memory: {
    resource: 'user-123',
    thread: 'conversation-123',
  },
})
Pour retrouver les informations stockées en mémoire, appelez l’agent avec les mêmes valeurs resource et thread que celles utilisées dans la conversation d’origine.
const response = await memoryAgent.generate("What's my favorite color?", {
  memory: {
    resource: 'user-123',
    thread: 'conversation-123',
  },
})

// Response: "Your favorite color is blue."
Chaque thread possède un propriétaire (resourceId) qui ne peut plus être modifié après sa création. Évitez de réutiliser le même ID de thread pour des threads appartenant à des propriétaires différents, car cela provoquera des erreurs lors des requêtes.
Pour répertorier tous les threads d’une ressource ou récupérer un thread précis, utilisez directement l’API Memory.
Observational MemoryLien direct vers Observational Memory
Lors des conversations longues, l’historique brut des messages s’allonge jusqu’à remplir la fenêtre de contexte, ce qui dégrade les performances de l’agent. Observational Memory résout ce problème en exécutant des agents en arrière-plan qui condensent les anciens messages en observations denses. La fenêtre de contexte reste ainsi réduite, sans perdre la mémoire à long terme.
import { Agent } from '@mastra/core/agent'
import { Memory } from '@mastra/memory'

export const memoryAgent = new Agent({
  id: 'memory-agent',
  name: 'Memory Agent',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
Consultez Observational Memory pour en savoir plus sur le fonctionnement des observations et des réflexions, ainsi que la référence pour connaître toutes les options de configuration.
Ce que voit le modèleLien direct vers Ce que voit le modèle
Chaque fonctionnalité de mémoire est ajoutée soit aux messages système, soit aux messages de conversation dans la requête envoyée au modèle. Les couches présentes dépendent des fonctionnalités activées. La mémoire de travail et le rappel sémantique n’apparaissent que s’ils sont configurés. Il en va de même pour Observational Memory, tandis que l’historique des messages est activé par défaut. Le schéma montre où chaque couche activée est placée dans la requête. La liste ci-dessous décrit la contribution de chaque couche :
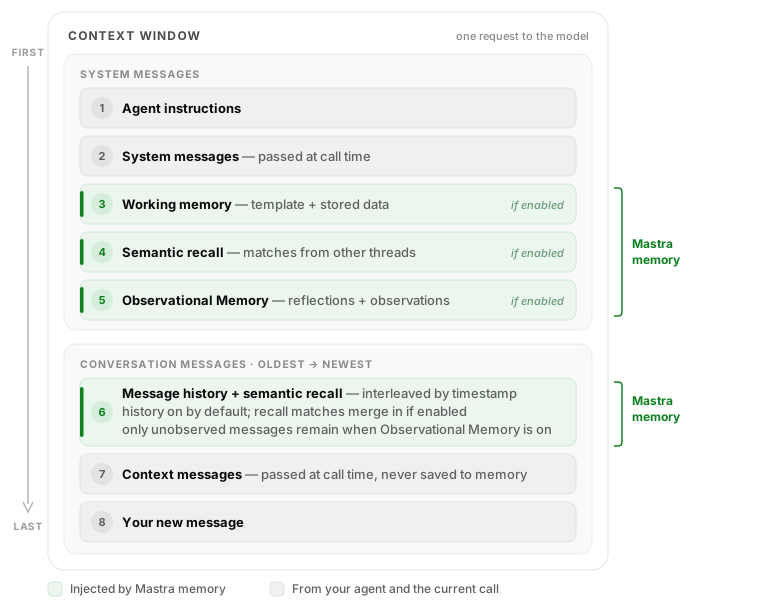
- La mémoire de travail est injectée sous la forme d’un message système contenant le gabarit et les données stockées. Avec
useStateSignals, elle est plutôt transmise sous forme de signal d’état. - Les correspondances du rappel sémantique issues du thread actuel sont insérées comme des messages ordinaires et intercalées dans l’historique des messages selon leur horodatage. Les correspondances provenant d’autres threads sont plutôt regroupées dans un message système.
- L’historique des messages ajoute les N derniers messages dans l’ordre chronologique. Votre nouveau message arrive toujours en dernier.
- Observational Memory remplace l’ancien historique brut : les réflexions et les observations figurent dans un message système, tandis que seuls les messages qui n’ont pas encore été observés restent dans la conversation. Un court rappel de continuité est placé au début des messages de conversation.
- Les messages de contexte correspondent au tableau facultatif
contexttransmis lors d’un appel, par exempleagent.generate(msg, { context: [...] }). Utilisez-les pour fournir ponctuellement du contexte, comme l’état de l’application ou vos propres résultats RAG. Ils apparaissent comme des messages de conversation ordinaires uniquement pour cette requête et ne sont jamais enregistrés dans Memory.
Les messages de conversation sont classés par horodatage et dédupliqués selon leur ID. Les anciens messages retrouvés apparaissent donc avant l’historique récent. Les messages de contexte transmis au moment de l’appel reçoivent l’horodatage actuel, ce qui les place après l’historique et le rappel, mais avant votre nouveau message. Pour examiner le contexte exact d’une requête réelle, utilisez le traçage et ouvrez les spans d’appel au LLM ; consultez la section Observabilité ci-dessous.
Memory dans les systèmes multi-agentsLien direct vers Memory dans les systèmes multi-agents
Lorsqu’un agent superviseur délègue une tâche à un sous-agent, Mastra isole automatiquement la mémoire de ce dernier. Aucun indicateur n’est nécessaire, car cette isolation s’applique à chaque délégation. Comprendre le fonctionnement de cette portée vous permet de choisir ce qui reste privé et ce que vous souhaitez partager délibérément.
Portée de la mémoire lors d’une délégationLien direct vers Portée de la mémoire lors d’une délégation
Chaque délégation crée un nouveau threadId et un resourceId déterministe pour le sous-agent :
- ID du thread : unique pour chaque délégation. Le sous-agent commence avec un historique de messages vierge à chaque appel.
- ID de la ressource : dérivé sous la forme
{parentResourceId}-{agentName}. Comme l’ID de la ressource reste stable d’une délégation à l’autre, la mémoire dont la portée est la ressource persiste entre les appels. Un sous-agent se souvient des faits issus des délégations précédentes effectuées par le même utilisateur. - Instance de Memory : un sous-agent qui ne possède pas sa propre mémoire hérite de l’instance
Memorydu superviseur et de toutes ses options configurées. Si le sous-agent définit sa propre instance, celle-ci est prioritaire.
La génération de titres (generateTitle) concerne les threads de premier niveau et ne s’applique pas aux threads hérités des sous-agents. Comme chaque délégation crée un thread éphémère que personne ne voit, générer un titre pour celui-ci gaspillerait un appel au LLM par délégation. Pour générer les titres des propres threads d’un sous-agent, attribuez-lui sa propre configuration de mémoire.
Le superviseur transmet le contexte de sa conversation au sous-agent afin que celui-ci dispose de suffisamment d’informations pour accomplir la tâche. Seuls le prompt de délégation et la réponse du sous-agent sont enregistrés ; l’intégralité de la conversation parente ne l’est pas. Vous pouvez contrôler les messages transmis au sous-agent grâce à la fonction de rappel messageFilter.
Les ID de ressource des sous-agents se terminent toujours par le nom de l’agent ({parentResourceId}-{agentName}). Des sous-agents différents rattachés au même superviseur ne partagent jamais un ID de ressource par le biais d’une délégation.
Pour dépasser cette isolation par défaut, vous pouvez partager la mémoire entre plusieurs agents en leur transmettant les mêmes identifiants lorsque vous les appelez directement.
Partager la mémoire entre plusieurs agentsLien direct vers Partager la mémoire entre plusieurs agents
Lorsque vous appelez directement des agents, en dehors du flux de délégation, le partage de la mémoire est contrôlé par deux identifiants : resourceId et threadId. Les agents qui utilisent les mêmes valeurs lisent et écrivent les mêmes données. Ce mécanisme est utile lorsque plusieurs agents collaborent dans un contexte commun, par exemple un chercheur qui enregistre des notes et un rédacteur qui les consulte.
Le partage à l’échelle de la ressource est le modèle le plus courant. La mémoire de travail et le rappel sémantique utilisent par défaut scope: 'resource'. Si deux agents partagent un resourceId, ils partagent les observations, la mémoire de travail et les embeddings, même dans des threads différents :
// Both agents share the same resource-scoped memory
await researcher.generate('Find information about quantum computing.', {
  memory: { resource: 'project-42', thread: 'research-session' },
})

await writer.generate('Write a summary from the research notes.', {
  memory: { resource: 'project-42', thread: 'writing-session' },
})
Comme les deux appels utilisent resource: 'project-42', le rédacteur peut accéder aux observations et à la mémoire de travail du chercheur. Les embeddings sémantiques sont également partagés par l’intermédiaire de la ressource. Chaque agent conserve néanmoins son propre thread, de sorte que les historiques de messages restent distincts.
Le partage à l’échelle du thread crée un couplage plus étroit. Observational Memory utilise par défaut scope: 'thread'. Si deux agents utilisent les mêmes resource et thread, ils partagent l’intégralité de l’historique des messages. Chaque agent voit tous les messages écrits par l’autre. Ce mécanisme est utile lorsque les agents doivent s’appuyer précisément sur les résultats produits par les autres.
ObservabilitéLien direct vers Observabilité
Activez le traçage pour surveiller et déboguer le fonctionnement de la mémoire. Les traces montrent exactement quels messages et quelles observations l’agent a inclus dans son contexte pour chaque requête. Elles vous aident ainsi à comprendre le comportement de l’agent et à vérifier que la récupération des éléments mémorisés fonctionne comme prévu.
Ouvrez Studio, puis sélectionnez l’onglet Observabilité dans la barre latérale. Ouvrez la trace d’une requête récente de l’agent et recherchez ses spans d’appel au LLM.
Changer de mémoire selon la requêteLien direct vers Changer de mémoire selon la requête
Utilisez RequestContext pour accéder aux valeurs propres à une requête. Vous pouvez ainsi sélectionner de manière conditionnelle différentes configurations de mémoire ou de stockage selon le contexte de la requête.
export type UserTier = {
  'user-tier': 'enterprise' | 'pro'
}

const premiumMemory = new Memory()
const standardMemory = new Memory()

export const memoryAgent = new Agent({
  id: 'memory-agent',
  name: 'Memory Agent',
  memory: ({ requestContext }) => {
    const userTier = requestContext.get('user-tier') as UserTier['user-tier']

    return userTier === 'enterprise' ? premiumMemory : standardMemory
  },
})
Consultez la page Contexte de requête pour en savoir plus.
Ressources associéesLien direct vers Ressources associées
- Référence de
Memory - Traçage
- Contexte de requête
- Mastra Code : un agent de programmation qui utilise le système Memory de Mastra