Observational Memory
Ajouté dans : @mastra/memory@1.1.0
Observational Memory (OM) est le système de Memory de Mastra destiné à la mémoire agentique à contexte long. Des Agents en arrière-plan, un Observer et un Reflector, suivent les conversations de votre Agent et tiennent un journal d’observations dense qui remplace l’historique brut des messages à mesure que celui-ci s’allonge.
Démarrage rapideLien direct vers Démarrage rapide
Vérifiez que @mastra/memory est installé dans votre projet. Définissez observationalMemory: true dans la configuration de Memory pour activer Observational Memory.
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
L’Agent dispose désormais d’une mémoire à long terme comparable à celle d’un humain, qui persiste d’une conversation à l’autre. Définir observationalMemory: true utilise google/gemini-2.5-flash par défaut. Pour employer un autre modèle, transmettez-le dans l’objet de configuration :
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
Consultez les options de configuration pour connaître tous les détails de l’API.
Lorsque vous utilisez OM avec une application cliente, envoyez uniquement le nouveau message depuis le client, et non l’intégralité de l’historique de la conversation.
Observational Memory repose toujours sur l’historique de conversation stocké. Envoyer l’historique complet est redondant et peut provoquer des erreurs d’ordre des messages lorsque les horodatages côté client entrent en conflit avec ceux qui sont stockés.
Pour un exemple avec AI SDK, consultez Utiliser Mastra Memory.
OM ne prend actuellement en charge que les adaptateurs de stockage @mastra/pg, @mastra/libsql, @mastra/mysql, @mastra/mongodb, @mastra/convex et @mastra/oracledb.
Il utilise des Agents en arrière-plan pour gérer la mémoire. Lorsqu’aucun modèle n’est défini, le modèle par défaut est google/gemini-2.5-flash.
Marqueurs d’intervalle temporelLien direct vers Marqueurs d’intervalle temporel
Les marqueurs d’intervalle temporel insèrent un bref rappel avant un nouveau message utilisateur lorsqu’un délai suffisant s’est écoulé depuis le message précédent du thread. Ils permettent à l’Agent et à l’interface de voir que la conversation a repris après une pause significative.
Les marqueurs d’intervalle temporel sont désactivés par défaut. Activez-les avec temporalMarkers: true dans la configuration observationalMemory :
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
Mastra insère un marqueur d’intervalle temporel lorsque l’interruption dure au moins 10 minutes. Le marqueur est stocké en mémoire et également émis sous forme d’événement de rappel transitoire, afin que les clients puissent l’afficher comme un repère discret dans la chronologie.
L’Observer voit également ces marqueurs lorsqu’il traite le thread. Les observations qu’il rédige peuvent ainsi rattacher les souvenirs au moment où ils se sont produits (par exemple : « L’utilisateur a posé une question sur le déploiement après une interruption de 2 jours »).
Consultez la référence de l’API pour connaître la structure complète de la configuration.
Activation anticipéeLien direct vers Activation anticipée
OM peut activer les observations mises en tampon avant que le seuil de tokens soit atteint. Cette fonctionnalité est utile lorsqu’un cache de prompt risque d’expirer ou lorsque l’Agent change de Provider de modèle.
Par défaut, les paramètres d’activation anticipée de premier niveau s’appliquent aux observations :
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
Utilisez les paramètres imbriqués observation et reflection pour contrôler chaque phase séparément. L’activation anticipée des réflexions doit être explicitement activée ; les paramètres de premier niveau n’affectent donc que les observations.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
Dans cet exemple, le paramètre d’inactivité de premier niveau est désactivé pour les observations, tandis que l’activation en cas d’inactivité et de changement de Provider est explicitement activée pour les réflexions.
Mise en tampon pendant l’inactivitéLien direct vers Mise en tampon pendant l’inactivité
Définissez observation.bufferOnIdle sur true pour lancer la mise en tampon des observations en arrière-plan lorsqu’un tour de l’Agent se termine et que celui-ci devient inactif. Cette option est utile pour les applications qui souhaitent observer les tours courts sans attendre le tour suivant ni l’atteinte du seuil messageTokens.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle est désactivé par défaut. Il est distinct de bufferTokens : bufferTokens contrôle la mise en tampon asynchrone pendant les étapes, tandis que bufferOnIdle contrôle la mise en tampon en fin de tour pour les tours inactifs.
Consultez la référence de l’API pour connaître la structure complète de la configuration.
AvantagesLien direct vers Avantages
- Mise en cache des prompts : le contexte d’OM est stable et les observations s’ajoutent au fil du temps au lieu d’être récupérées à l’exécution à chaque tour. Le préfixe du prompt peut ainsi rester en cache, ce qui réduit les coûts.
- Compression : l’historique brut des messages et les résultats des Tools sont compressés dans un journal d’observations dense. Un contexte plus réduit permet des réponses plus rapides et des conversations cohérentes plus longues.
- Aucune dégradation du contexte : l’Agent voit les informations pertinentes plutôt que des appels de Tools parasites et des tokens sans intérêt. Il reste ainsi concentré sur sa tâche pendant les longues sessions.
FonctionnementLien direct vers Fonctionnement
Vous ne vous souvenez pas de chaque mot de toutes les conversations que vous avez eues. Vous observez inconsciemment ce qui s’est passé, puis votre cerveau y réfléchit, réorganise et combine les informations, avant de les condenser en mémoire à long terme. OM fonctionne de la même manière.
Chaque fois qu’un Agent répond, il voit une fenêtre de contexte contenant son prompt système, l’historique récent des messages et tout contexte injecté. Cette fenêtre est limitée. Même les modèles dotés de limites de tokens élevées sont moins performants lorsqu’elle est pleine. Cela entraîne deux problèmes :
- Dégradation du contexte : plus un Agent transporte d’historique brut des messages, plus ses performances diminuent.
- Gaspillage de contexte : la majeure partie de cet historique contient des tokens qui ne sont plus nécessaires pour maintenir l’Agent concentré sur sa tâche.
OM résout ces deux problèmes en compressant l’ancien contexte sous forme d’observations denses.
ObservationsLien direct vers Observations
Lorsque le nombre de tokens de l’historique des messages dépasse un seuil (30 000 par défaut), l’Observer crée des observations, c’est-à-dire des notes concises sur ce qui s’est passé :
OM utilise une estimation locale rapide des tokens pour déterminer le franchissement de ce seuil. Le texte est estimé avec tokenx, tandis que les parties image utilisent des heuristiques tenant compte du Provider, afin que les conversations multimodales déclenchent toujours l’observation au bon moment. Il en va de même pour les parties file assimilables à des images lorsqu’un transport normalise une image téléversée en fichier plutôt qu’en partie image. Par exemple, les paramètres de niveau de détail des images d’OpenAI peuvent modifier sensiblement le moment où OM décide d’observer.
L’Observer peut également voir les pièces jointes dans l’historique qu’il examine. Pour faciliter la lecture, OM conserve dans la transcription des espaces réservés lisibles tels que [Image #1: reference-board.png] ou [File #1: floorplan.pdf], et transmet les véritables parties jointes avec le texte. Lorsque cela est possible, les parties file assimilables à des images sont converties en entrées image pour l’Observer, tandis que les pièces jointes qui ne sont pas des images sont transmises comme parties fichier avec un comptage normalisé des tokens. Cela s’applique aussi bien à l’observation normale d’un thread qu’à l’observation par lots au niveau d’une ressource.
ExtractorsLien direct vers Extractors
Utilisez des Extractors lorsque vous souhaitez qu’OM conserve des valeurs précises avec les observations. Les valeurs intégrées telles que la tâche actuelle, la réponse suggérée et le titre du thread utilisent le même pipeline d’extraction que les valeurs personnalisées.
L’exemple suivant extrait un profil utilisateur compact à partir des observations :
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
L’ajout d’un schema exécute l’Extractor sous la forme d’une requête de sortie structurée complémentaire. Les Extractors sans schéma extraient des chaînes en ligne, émises directement dans la réponse de l’Observer ou du Reflector.
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
Par défaut, OM présente à l’Extractor la dernière valeur extraite lors des exécutions suivantes. Définissez includePreviousExtraction: false lorsque l’Observer ne doit pas voir la valeur précédente.
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
Utilisez des fonctions instructions ou schema évaluées à l’exécution lorsqu’un Extractor a besoin du contexte d’exécution, comme l’instance de Memory active ou le contexte de la requête :
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
Lire les valeurs extraites depuis un streamLien direct vers Lire les valeurs extraites depuis un stream
Les résultats des Extractors sont émis lorsqu’OM termine une observation ou une réflexion. Lisez les deux parties de données d’achèvement depuis le stream :
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues utilise le slug de chaque Extractor comme clé. Les deux champs de résultat sont facultatifs, et l’échec d’un Extractor ne supprime pas les valeurs produites par les autres Extractors.
data-om-observation-end signale un achèvement synchrone. data-om-buffering-end signale l’achèvement d’un traitement en arrière-plan. Les métadonnées des Extractors sont conservées immédiatement, mais le contenu mis en tampon reste inactif jusqu’à son activation. Consultez operationType pour déterminer si le traitement achevé était une observation ou une réflexion.
Consultez les tableaux de référence de data-om-observation-end et data-om-buffering-end pour connaître les payloads complets.
Mises à jour de la Working MemoryLien direct vers Mises à jour de la Working Memory
Utilisez observationalMemory.observation.manageWorkingMemory pour permettre à l’Observer de gérer automatiquement la Working Memory. L’Agent principal n’a alors plus besoin d’appeler le Tool de Working Memory pendant qu’il traite la requête de l’utilisateur ; les mises à jour de la Working Memory ne dépendent donc plus du fait que l’Agent pense à les effectuer.
Cela permet également à la Working Memory de rester compatible avec la mise en cache des prompts. Elle se trouve normalement dans le prompt système ; ses mises à jour peuvent donc invalider le cache du prompt. Pour la Working Memory gérée par OM, workingMemory.useStateSignals vaut true par défaut, ce qui déplace la Working Memory vers les signaux d’état.
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
Ce paramètre ajoute WorkingMemoryExtractor, définit workingMemory.agentManaged sur false par défaut et définit workingMemory.useStateSignals sur true par défaut. Définissez workingMemory.agentManaged: true si l’Agent principal doit toujours recevoir le Tool de Working Memory et l’injection d’instructions correspondante.
Utilisez onExtracted pour normaliser les valeurs personnalisées extraites ou y réagir avant leur enregistrement :
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
Les échecs des Extractors sont signalés dans les marqueurs d’OM et ne bloquent pas les valeurs produites avec succès par les autres Extractors. Consultez la référence de l’API pour connaître la structure complète d’un Extractor.
Si votre modèle d’Observer accepte uniquement le texte ou si son API refuse les entrées multimodales, définissez observation.observeAttachments sur false afin de retirer les pièces jointes avant qu’elles n’atteignent l’Observer. Les espaces réservés lisibles ([Image #1: ...], [File #1: ...]) restent dans la transcription ; l’Observer peut ainsi raisonner sur ce qui a été partagé sans recevoir le payload binaire. Le même filtre s’applique aux résultats de Tools qui contiennent des parties image ou fichier :
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
Vous pouvez également transmettre une liste d’autorisation de motifs glob mimeType (par exemple ['image/*']) afin de ne transmettre que les types que l’Observer sait traiter. Vous pouvez aussi définir observeAttachments: 'auto' pour laisser Mastra décider à partir du registre des capacités du Provider : les pièces jointes sont transmises lorsque le modèle de l’Observer prend en charge les entrées multimodales, et retirées dans le cas contraire. Si aucune donnée de capacité n’est disponible pour le modèle, la valeur de repli est true.
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
Le taux de compression est généralement compris entre 5x et 40x. L’Observer suit également une tâche actuelle et une réponse suggérée, afin que l’Agent reprenne là où il s’était arrêté.
Si vous activez observation.threadTitle, l’Observer peut également proposer un titre de thread court lorsque le sujet de la conversation change de manière significative. La génération du titre doit être explicitement activée et met à jour les métadonnées du thread ; des applications comme Mastra Code peuvent ainsi afficher le titre le plus récent dans les listes de threads et l’interface d’état.
Exemple : un Agent utilisant Playwright MCP peut recevoir plus de 50 000 tokens par instantané de page. Avec OM, l’Observer suit l’interaction et crée quelques centaines de tokens d’observations sur le contenu de la page et les actions effectuées. L’Agent reste concentré sur sa tâche sans transporter chaque instantané brut.
RéflexionsLien direct vers Réflexions
Lorsque les observations dépassent leur seuil (40 000 tokens par défaut), le Reflector les condense, combine les éléments liés et analyse les tendances.
Les réflexions ne s’accumulent pas dans une couche distincte en croissance continue. Chaque réflexion réécrit l’intégralité du journal d’observations. La sortie du Reflector devient le nouveau journal, auquel les nouvelles observations sont ensuite ajoutées. Lorsque le journal atteint de nouveau le seuil, le Reflector retraite l’ensemble, y compris les réflexions antérieures. Il condense plus fortement les informations anciennes tout en conservant les détails récents. La Memory reste limitée autour du seuil de réflexion, quelle que soit la durée de la conversation.
On obtient ainsi un système à trois niveaux :
- Messages récents : historique exact de la conversation pour la tâche actuelle
- Observations : journal de ce que l’Observer a vu
- Réflexions : observations condensées lorsque la mémoire devient trop longue
Évolution du contexte au fil du tempsLien direct vers Évolution du contexte au fil du temps
Avec les paramètres par défaut, la fenêtre de contexte ne croît pas sans limite. Elle oscille selon un cycle d’observation et de réduction :
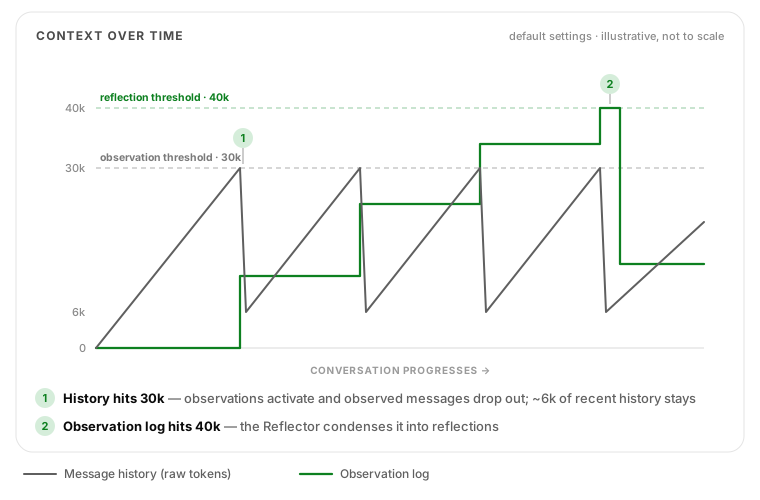
- 0 → 30k tokens : l’historique des messages augmente normalement. En arrière-plan, l’Observer met des observations en tampon tous les ~6k tokens (
bufferTokens: 0.2). - Seuil de 30k atteint : les observations mises en tampon s’activent immédiatement. Les messages observés sont retirés de la fenêtre de contexte et il ne reste qu’environ ~6k tokens d’historique récent (
bufferActivation: 0.8conserve 20 % du seuil). Les ~24k tokens de messages retirés deviennent environ 1 à 5k tokens d’observations avec un taux de compression habituel de 5 à 40x. - Répétition : l’historique repart de ~6k, remonte vers 30k, puis se réduit à nouveau. Chaque cycle ajoute des éléments au journal d’observations, dont la croissance est bien plus lente que celle de l’historique brut.
- Les observations atteignent 40k : le Reflector crée un journal plus réduit à partir des observations actuelles et des éventuelles réflexions antérieures.
Dans le cycle normal avec mise en tampon, l’historique brut oscille entre environ 6k et 30k tokens. Le journal d’observations reste autour de 40k tokens, quelle que soit la durée de la conversation. Il s’agit de seuils d’activation, et non de limites strictes. Si la mise en tampon en arrière-plan ne suit pas le rythme, l’historique peut dépasser le seuil jusqu’à ce que blockAfter (1.2 par défaut) impose une observation synchrone à ~36k tokens (~48k pour la réflexion), comme plafond de sécurité.
Lorsque shareTokenBudget est activé, les deux budgets sont regroupés. Tant que le journal d’observations est réduit, l’historique des messages peut occuper l’espace inutilisé du budget d’observation (jusqu’à ~70k tokens avec les valeurs par défaut) avant le déclenchement de l’observation. Il diminue ensuite à mesure que les observations s’accumulent.
Mode de récupérationLien direct vers Mode de récupération
Dans son fonctionnement normal, OM compresse les messages en observations, ce qui aide à rester concentré sur la tâche, mais fait disparaître la formulation d’origine. Le mode de récupération résout ce problème en maintenant un lien entre chaque groupe d’observations et les messages bruts dont il provient. Lorsque l’Agent a besoin d’une formulation exacte, d’une sortie de Tool ou d’une chronologie supprimée par la compression du résumé, il peut appeler un Tool recall pour parcourir les messages sources page par page.
Navigation uniquementLien direct vers Navigation uniquement
Définissez retrieval: true pour activer le Tool recall et parcourir les messages bruts. Aucun Vector Store n’est nécessaire. Par défaut, le Tool recall peut parcourir tous les threads de la ressource actuelle.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
Avec la recherche sémantiqueLien direct vers Avec la recherche sémantique
Définissez retrieval: { vector: true } pour activer également la recherche sémantique. Cette option réutilise le Vector Store et l’Embedder déjà configurés sur votre instance de Memory :
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
Lorsque la recherche vectorielle est configurée, les nouveaux groupes d’observations sont automatiquement indexés lors de leur mise en tampon et pendant l’observation synchrone, sans attente ni blocage. La recherche sémantique renvoie les groupes d’observations correspondants avec les plages d’identifiants de leurs messages sources bruts ; le Tool recall peut ainsi afficher la mémoire résumée avec son origine.
Limiter au thread actuelLien direct vers Limiter au thread actuel
Par défaut, le scope du Tool recall est 'resource' : l’Agent peut répertorier les threads, parcourir d’autres threads et effectuer des recherches dans toutes les conversations. Définissez scope: 'thread' pour limiter l’Agent au thread actuel :
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
Instructions recall personnaliséesLien direct vers Instructions recall personnalisées
Mastra injecte des instructions tenant compte du scope, qui indiquent à l’Agent quand effectuer une recherche, répertorier les threads ou lire un thread précis. Utilisez instructions pour ajouter des recommandations propres à l’application après ces instructions intégrées. Les instructions intégrées ne sont jamais remplacées :
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
Les recommandations propres à recall restent ainsi attachées au Tool recall plutôt qu’aux instructions globales de l’Agent, et n’affectent donc pas les tâches sans rapport.
Fonctionnalités du mode de récupérationLien direct vers Fonctionnalités du mode de récupération
Lorsque le mode de récupération est activé, OM :
- stocke une
range(par exemplestartId:endId) sur chaque groupe d’observations, qui pointe vers les messages dont il est issu ; - conserve les métadonnées de plage visibles dans le contexte de l’Agent, afin que celui-ci sache quelles observations correspondent à quels messages ;
- enregistre un Tool
recallque l’Agent peut appeler pour :- parcourir page par page les messages bruts associés à la plage de n’importe quel groupe d’observations ;
- effectuer une recherche par similarité sémantique (
mode: "search"avec une chaînequery) ; nécessitevector: true; - répertorier tous les threads (
mode: "threads"), parcourir d’autres threads (threadId) et effectuer des recherches dans tous les threads (scope: 'resource'par défaut) ; - lorsque
scope: 'thread', limiter la navigation et la recherche au thread actuel.
Consultez la référence du Tool recall pour découvrir l’API complète : niveaux de détail, indexation des parties, pagination, navigation entre threads et limitation des tokens.
StudioLien direct vers Studio
Pour voir son fonctionnement en pratique, ouvrez Studio et accédez à un Agent sur lequel OM est activé. L’onglet Memory affiche :
-
Barres de progression des tokens : le nombre actuel de tokens des messages et des observations, indiquant la proximité de chaque seuil. Survolez l’icône d’information pour voir le modèle et le seuil de l’Observer et du Reflector.
-
Observations actives : le journal d’observations actuel est affiché directement. S’il existe des enregistrements d’observations ou de réflexions antérieurs, développez « Observations précédentes » pour les parcourir.
-
Traitement en arrière-plan : pendant une conversation, les blocs d’observations mis en tampon et l’état de la réflexion apparaissent à mesure que l’Agent effectue le traitement en arrière-plan.
Les barres de progression s’actualisent en temps réel pendant que l’Agent observe ou réfléchit, et affichent le temps écoulé ainsi qu’un badge d’état.
ModèlesLien direct vers Modèles
L’Observer et le Reflector s’exécutent en arrière-plan. Vous pouvez utiliser tout modèle compatible avec le routage des modèles de Mastra (provider/model). Lorsqu’aucun modèle n’est défini, le modèle par défaut est google/gemini-2.5-flash.
Mastra recommande d’utiliser un modèle doté d’une grande fenêtre de contexte (au moins 128K tokens) et suffisamment rapide pour s’exécuter en arrière-plan sans ralentir vos actions.
Si vous ne savez pas quel modèle choisir, commencez par le modèle par défaut google/gemini-2.5-flash. Nous avons également testé avec succès openai/gpt-5-mini, anthropic/claude-haiku-4-5, deepseek/deepseek-reasoner, deepseek/deepseek-v4-pro, deepseek/deepseek-v4-flash, xai/grok-4-1-fast, qwen3 et glm-4.7.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
Consultez la configuration des modèles pour utiliser des modèles différents selon l’Agent.
google/gemini-2.5-flash est particulièrement performant pour préserver les détails dans les sorties longues. Par conséquent, le Reflector peut produire des réflexions qui restent au-dessus du seuil reflection.observationTokens configuré, même après le nombre maximal de nouvelles tentatives de compression. Dans ce cas, le Reflector renvoie le plus petit candidat non dégénéré produit au cours des tentatives, afin que la boucle se termine au lieu de s’exécuter indéfiniment.
Si vous préférez une compression plus forte de la part du Reflector, optez pour un modèle qui condense plus facilement, comme xai/grok-4-1-fast, deepseek/deepseek-v4-pro ou deepseek/deepseek-v4-flash. Vous pouvez conserver google/gemini-2.5-flash pour l’Observer et utiliser un autre modèle pour le Reflector. Consultez la section Modèles différents selon l’Agent.
Sélection du modèle par palier de tokensLien direct vers Sélection du modèle par palier de tokens
Ajouté dans : @mastra/memory@1.10.0
Vous pouvez utiliser ModelByInputTokens pour définir différents modèles d’Observer ou de Reflector en fonction du nombre de tokens d’entrée. À l’exécution, OM sélectionne le palier de modèle correspondant parmi les seuils upTo configurés.
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
Les clés upTo représentent des limites supérieures inclusives. OM calcule le nombre réel de tokens d’entrée de l’appel à l’Observer ou au Reflector, détermine directement le palier correspondant, puis utilise ce modèle concret pour l’exécution.
Si l’entrée dépasse le plus grand seuil configuré, une erreur est générée. Assurez-vous que vos seuils couvrent toute la plage des tailles d’entrée possibles, ou utilisez au palier le plus élevé un modèle doté d’une fenêtre de contexte suffisamment grande.
ScopesLien direct vers Scopes
Scope du thread (par défaut)Lien direct vers Scope du thread (par défaut)
Chaque thread possède ses propres observations. Ce scope a été rigoureusement testé et convient bien comme système de mémoire polyvalent, en particulier pour les cas d’usage agentiques de longue durée.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
Le scope du thread exige qu’un threadId valide soit fourni lors de l’appel à l’Agent. Si threadId est absent, Observational Memory génère une erreur. Cela empêche plusieurs threads de partager silencieusement un même enregistrement d’observations, ce qui peut provoquer des interblocages dans la base de données.
Scope de la ressource (expérimental)Lien direct vers Scope de la ressource (expérimental)
Les observations sont partagées entre tous les threads d’une ressource, généralement un utilisateur. Cela permet une mémoire inter-conversations.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'resource',
    },
  },
})
Le scope de la ressource fonctionne, mais il est pour l’instant considéré comme expérimental, jusqu’à ce que nous ayons validé le respect et la continuité des tâches sur plusieurs threads simultanés en cours. À ce jour, vous devrez peut-être ajuster votre prompt système pour empêcher un thread de poursuivre le travail qu’un autre a déjà commencé sans l’avoir terminé.
En effet, dans le scope de la ressource, chaque thread constitue une perspective sur tous les threads de cette ressource.
Selon votre cas d’usage, cela peut ne poser aucun problème ; les résultats peuvent donc varier.
Dans le scope de la ressource, les messages non observés de tous les threads sont traités ensemble. Ce traitement peut être lent pour les utilisateurs qui disposent de nombreux threads. Pour les applications existantes, utilisez le scope du thread.
Budgets de tokensLien direct vers Budgets de tokens
OM utilise des seuils de tokens pour décider quand observer et réfléchir. Consultez la configuration des budgets de tokens pour plus de détails.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
Cache de comptage des tokensLien direct vers Cache de comptage des tokens
OM met en cache les estimations de tokens dans les métadonnées des messages afin de limiter les comptages répétés lors des vérifications de seuil et des décisions de mise en tampon.
- Les estimations de chaque partie sont stockées dans
part.providerMetadata.mastraet réutilisées lors des passages suivants lorsque la version du cache et la source du tokenizer correspondent. - Pour le contenu des messages constitué uniquement d’une chaîne, sans parties, OM utilise un cache de repli dans les métadonnées du message.
- Le surcoût des messages et de la conversation est toujours recalculé à chaque passage. Le cache ne stocke que les estimations du payload ; la sémantique du comptage reste donc identique.
- Les parties
data-*etreasoningsont toujours ignorées et ne sont pas mises en cache.
Estimations de tokens fournies par l’appelant pour les parties fichierLien direct vers Estimations de tokens fournies par l’appelant pour les parties fichier
Vous pouvez associer directement une estimation de tokens à une partie image ou file avec providerMetadata.mastra.tokenEstimate. Le Token Counter respecte cette valeur telle quelle et n’utilise pas son propre estimateur :
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
L’objet tokenEstimate adopte la même structure que celle utilisée en interne par le Token Counter pour les estimations mises en cache :
v: version du schéma du cache. Définissez-la sur0. Les entrées fournies par l’appelant sont exemptées de la vérification de version du framework ; cette valeur n’est donc pas lue.source: marqueur d’origine du cache. Doit valoir'client'. Il indique au Token Counter que l’entrée fait autorité et doit être respectée telle quelle, au lieu d’être recalculée ou remplacée.key: emplacement de l’empreinte du contenu. Définissez-le sur'client'. Les entrées du framework y utilisent un hash du contenu afin d’être invalidées lorsque le payload change. La sentinelle'client'maintient la stabilité des estimations de l’appelant entre les écritures.tokens: nombre de tokens à utiliser. Doit être un nombre fini supérieur ou égal à zéro.
Remarques supplémentaires :
- L’estimation n’est prise en compte que sur les parties
imageetfile. Les partiestextettool-invocationsont toujours comptées normalement, même si elles contiennent untokenEstimate.
Mise en tampon asynchroneLien direct vers Mise en tampon asynchrone
Sans mise en tampon asynchrone, l’Observer s’exécute de manière synchrone lorsque le seuil des messages est atteint : l’Agent marque une pause au milieu de la conversation pendant l’appel LLM de l’Observer. Avec la mise en tampon asynchrone, activée par défaut, les observations sont précalculées en arrière-plan à mesure que la conversation s’allonge. Lorsque le seuil est atteint, les observations mises en tampon s’activent immédiatement, sans pause.
FonctionnementLien direct vers Fonctionnement
Au fil de la conversation de l’Agent, les tokens des messages s’accumulent. À intervalles réguliers (bufferTokens), un appel à l’Observer s’exécute en arrière-plan sans bloquer l’Agent. Chaque appel produit un « bloc » d’observations stocké dans un tampon.
Lorsque les tokens des messages atteignent le seuil messageTokens, les blocs mis en tampon s’activent : leurs observations sont transférées dans le journal d’observations actif et les messages bruts correspondants sont retirés de la fenêtre de contexte. L’Agent ne marque aucune pause.
Les observations mises en tampon comprennent également des indications de continuation, une suggestion de prochaine réponse et la tâche actuelle. L’Agent principal préserve ainsi la continuité de la conversation après la réduction de la fenêtre de contexte provoquée par l’activation.
Si l’Agent produit des messages plus vite que l’Observer ne peut les traiter, un seuil de sécurité blockAfter impose une observation synchrone en dernier recours. L’activation du tampon préserve malgré tout un contexte restant minimal : la plus petite valeur entre ~1k tokens et le plancher de conservation configuré.
La réflexion fonctionne de façon similaire : le Reflector s’exécute en arrière-plan lorsque les observations atteignent une fraction du seuil de réflexion.
ParamètresLien direct vers Paramètres
| Paramètre | Valeur par défaut | Élément contrôlé |
|---|---|---|
observation.bufferTokens | 0.2 | Fréquence de mise en tampon. 0.2 signifie tous les 20 % de messageTokens. Avec le seuil par défaut de 30k, cela correspond à environ 6k tokens. Peut également être un nombre absolu de tokens, par exemple 5000. |
observation.bufferActivation | 0.8 | Intensité du nettoyage de la fenêtre de messages lors de l’activation. 0.8 signifie que suffisamment de messages sont supprimés pour ne conserver que 20 % de messageTokens. Des valeurs plus faibles conservent davantage d’historique. |
observation.blockAfter | 1.2 | Filet de sécurité si la mise en tampon ne suit pas le rythme. Les valeurs de 1 à 100 exclus multiplient messageTokens : avec 1.2, une observation synchrone est imposée à 36k tokens (1,2 × 30k). Les valeurs supérieures ou égales à 100 représentent un nombre absolu de tokens, par exemple 50_000. |
activateAfterIdle | aucune | Force l’activation des observations mises en tampon après une période d’inactivité, avant même que observation.messageTokens soit atteint. Accepte une valeur numérique en millisecondes telle que 300_000, des chaînes de durée comme "5m" ou "1hr", ou "auto" pour un TTL de cache de prompt tenant compte du Provider. |
activateOnProviderChange | false | Force l’activation des observations mises en tampon lorsque l’étape suivante utilise un provider/model différent de celui qui a produit la dernière étape de l’assistant. Utilisez ce paramètre lorsqu’un changement de Provider ou de modèle invaliderait la réutilisation du cache du prompt. |
reflection.bufferActivation | 0.5 | Moment où commencer la réflexion en arrière-plan. 0.5 signifie que la réflexion débute lorsque les observations atteignent 50 % du seuil observationTokens. |
reflection.activateAfterIdle | aucune | Active l’activation des réflexions mises en tampon en cas d’inactivité. Les réflexions n’héritent pas du paramètre de premier niveau activateAfterIdle. |
reflection.activateOnProviderChange | false | Active l’activation des réflexions mises en tampon lors d’un changement de Provider. Les réflexions n’héritent pas du paramètre de premier niveau activateOnProviderChange. |
reflection.blockAfter | 1.2 | Seuil de sécurité de la réflexion, selon la même logique que pour l’observation. |
Si vous comptez sur la mise en cache des prompts, définissez activateAfterIdle sur "auto" ou sur un TTL de cache précis. Ainsi, lorsqu’un thread est resté inactif assez longtemps pour que le cache expire, la requête suivante peut d’abord activer les observations mises en tampon et envoyer une fenêtre de contexte compressée plus petite.
Avec "auto", Mastra choisit un TTL d’activation après inactivité en fonction du Provider du modèle actif :
| Provider | TTL automatique |
|---|---|
| Anthropic, OpenRouter, Providers inconnus, xAI | 5 minutes |
| DeepSeek | 1 heure |
| Google Gemini | 24 heures |
| Groq | 2 heures |
OpenAI avec providerOptions.openai.promptCacheRetention: "24h" | 1 heure |
OpenAI avec providerOptions.openai.promptCacheRetention: "in_memory" | 5 minutes |
OpenAI gpt-4*, gpt-5, gpt-5-* et de gpt-5.1 à gpt-5.4, y compris les variantes dotées d’un suffixe - | 5 minutes |
| Autres modèles OpenAI | 1 heure |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
Avec "auto", les observations mises en tampon sont activées selon le comportement du cache de prompt du Provider actif. Le prochain prompt non mis en cache utilise ainsi des observations compressées plutôt qu’une fenêtre plus grande de messages bruts. Si vous préférez un TTL fixe de 5 minutes, utilisez "5m" ou 300_000.
Changer de modèle ou de Provider au milieu d’un thread invalide le cache du prompt. Si votre Agent peut changer de Provider ou de modèle en cours de thread, activateOnProviderChange: true force l’activation des observations mises en tampon avant l’exécution du nouveau Provider. Cela évite d’envoyer une grande fenêtre brute à un Provider qui ne peut pas réutiliser le cache du prompt précédent.
DésactivationLien direct vers Désactivation
Pour désactiver la mise en tampon asynchrone et utiliser à la place l’observation et la réflexion synchrones :
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
Définir bufferTokens: false désactive la mise en tampon asynchrone pour l’observation comme pour la réflexion. Consultez la configuration de la mise en tampon asynchrone pour connaître l’API complète.
La mise en tampon asynchrone n’est pas prise en charge avec scope: 'resource'. Elle est automatiquement désactivée dans le scope de la ressource.
Optimisation du contexte de l’ObserverLien direct vers Optimisation du contexte de l’Observer
Par défaut, l’Observer reçoit l’historique complet des observations comme contexte lorsqu’il traite de nouveaux messages. Il reçoit également les métadonnées current-task et suggested-response antérieures lorsqu’elles sont disponibles, afin de conserver ses repères même si le contexte d’observation est tronqué. Pour les conversations longues dont les observations deviennent volumineuses, vous pouvez activer l’optimisation du contexte afin de réduire le coût des entrées de l’Observer.
Définissez observation.previousObserverTokens pour limiter le nombre de tokens d’observations antérieures envoyés à l’Observer. Les observations sont tronquées au début afin de conserver les entrées les plus récentes. Lorsqu’une réflexion mise en tampon est en attente, les lignes déjà traitées par cette réflexion sont automatiquement remplacées par son résumé avant l’application de la troncature.
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: 2000→ valeur par défaut. Conserve ~2k tokens d’observations récentes.previousObserverTokens: 0→ omet complètement les observations antérieures.previousObserverTokens: false→ désactive la troncature et conserve l’intégralité des observations antérieures.
Migrer des threads existantsLien direct vers Migrer des threads existants
Aucune migration manuelle n’est nécessaire. OM lit les messages existants et les observe à la demande lorsque les seuils sont dépassés.
- Scope du thread : la première fois qu’un thread dépasse
observation.messageTokens, l’Observer traite les messages en attente. - Scope de la ressource : tous les messages non observés de tous les threads d’une ressource sont traités ensemble. Pour les utilisateurs disposant de nombreux threads, cela peut prendre beaucoup de temps.
Comparer OM aux autres fonctionnalités de mémoireLien direct vers Comparer OM aux autres fonctionnalités de mémoire
- Historique des messages : enregistrement haute fidélité de la conversation actuelle
- Working Memory : petit état structuré (JSON ou Markdown) pour les préférences, les noms et les objectifs des utilisateurs
- Semantic Recall : récupération fondée sur la RAG des anciens messages pertinents
- Threads multi-utilisateurs : manière dont OM attribue les faits à chaque utilisateur lorsque plusieurs personnes partagent un même thread
Si vous utilisez la Working Memory pour stocker des résumés de conversations ou un état continu qui s’enrichit au fil du temps, OM est plus adapté. La Working Memory est destinée aux petites quantités de données structurées ; OM convient aux journaux d’événements de longue durée. OM gère également automatiquement l’historique des messages : le paramètre messageTokens contrôle la quantité d’historique brut qui subsiste avant le lancement de l’observation.
En pratique, OM remplace à la fois la Working Memory et l’historique des messages, tout en offrant une précision supérieure à Semantic Recall pour un coût inférieur.
Ressources connexesLien direct vers Ressources connexes
- Référence d’Observational Memory
- Présentation de Memory
- Historique des messages
- Processors de Memory
- Mastra Code : un Agent de programmation utilisant Observational Memory
- 📹 Atelier sur les Processors Mastra et Observational Memory