Observational Memory
新增于:@mastra/memory@1.1.0
Observational Memory(OM)是 Mastra 面向长上下文 Agentic Memory 的 Memory 系统。两个后台 Agent——Observer 和 Reflector——会观察 Agent 的对话,并维护一份密集的观察日志;随着原始消息历史增长,该日志会取代原始历史。
快速开始快速开始的直接链接
确保项目中已安装 @mastra/memory。在 Memory 配置中设置 observationalMemory: true 即可启用 Observational Memory。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
现在,Agent 拥有了可跨对话持久化、类似人类的长期 Memory。设置 observationalMemory: true 默认使用 google/gemini-2.5-flash。要使用其他模型,请在配置对象中传入:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
完整 API 详情请参阅配置选项。
在客户端应用中使用 OM 时,请从客户端仅发送新消息,不要发送完整对话历史。
Observational Memory 仍依赖已存储的对话历史。发送完整历史既多余,也可能在客户端时间戳与已存储时间戳冲突时导致消息排序错误。
有关 AI SDK 示例,请参阅使用 Mastra Memory。
OM 目前仅支持 @mastra/pg、@mastra/libsql、@mastra/mysql、@mastra/mongodb、@mastra/convex 和 @mastra/oracledb Storage Adapter。
它使用后台 Agent 管理 Memory。未设置模型时,默认模型为 google/gemini-2.5-flash。
时间间隔标记时间间隔标记的直接链接
如果距离 Thread 中上一条消息已过去足够长时间,时间间隔标记会在新用户消息前插入一条简短提醒。它能帮助 Agent 和 UI 看出对话是在一段有意义的停顿后恢复的。
时间间隔标记默认关闭。在 observationalMemory 配置中设置 temporalMarkers: true 即可启用:
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
间隔至少为 10 分钟时,Mastra 会插入时间间隔标记。该标记会存入 Memory,并作为临时提醒事件发出,客户端可将其渲染为轻量的时间线提示。
Observer 处理 Thread 时也能看到这些标记,因此写入的观察结果可以与发生时间关联(例如“间隔 2 天后,用户询问了部署问题”)。
完整配置结构请参阅 API 参考。
提前激活提前激活的直接链接
OM 可以在达到 token 阈值之前激活已缓冲的观察结果。这适合提示词缓存可能过期,或 Agent 更换模型 Provider 的情况。
顶层提前激活设置默认应用于观察阶段:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
使用嵌套的 observation 和 reflection 设置可以逐阶段控制。反思阶段的提前激活需要显式选择启用,因此顶层设置只影响观察阶段。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
此示例为观察阶段禁用顶层空闲设置,同时为反思阶段启用空闲和 Provider 变更激活。
空闲时缓冲空闲时缓冲的直接链接
将 observation.bufferOnIdle 设为 true,可以在 Agent 轮次结束并进入空闲状态时运行后台观察缓冲。这样,短轮次无需等待下一轮或达到 messageTokens 阈值也能被观察。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle 默认关闭。它与 bufferTokens 相互独立:bufferTokens 控制步骤执行期间的异步缓冲,bufferOnIdle 控制空闲轮次在结束时进行缓冲。
完整配置结构请参阅 API 参考。
优势优势的直接链接
- 提示词缓存:OM 的上下文稳定,观察结果会随时间追加,而不是在每一轮运行时检索。这使提示词前缀可缓存,从而降低成本。
- 压缩:原始消息历史和 Tool 结果会被压缩为密集的观察日志。更小的上下文意味着响应更快,对话也能更长时间保持连贯。
- 上下文不会腐化:Agent 会看到相关信息,而不是嘈杂的 Tool 调用和无关 token,因此能在长会话中始终专注于任务。
工作原理工作原理的直接链接
你不会记住一生中每次对话的每个字。你会下意识地观察发生了什么,然后大脑进行反思、重组、合并和浓缩,形成长期记忆。OM 的工作方式与此相同。
Agent 每次响应时,都会看到一个包含系统提示词、近期消息历史和所有注入上下文的上下文窗口。上下文窗口是有限的,即使 token 限制很大的模型在窗口填满时表现也会变差。这会产生两个问题:
- 上下文腐化:Agent 携带的原始消息历史越多,表现就越差。
- 上下文浪费:历史中的大部分 token 已经不再是 Agent 保持任务专注所必需的。
OM 通过将旧上下文压缩为密集的观察结果来解决这两个问题。
观察结果观察结果的直接链接
当消息历史 token 超过阈值(默认 30,000)时,Observer 会创建观察结果,即对所发生事件的简洁记录:
OM 使用快速的本地 token 估算来判断是否达到此阈值。文本通过 tokenx 估算,图像部分则使用能够感知 Provider 的启发式方法,让多模态对话也能在正确时机触发观察。传输层将上传图像规范化为文件部分时,类似图像的 file 部分同样适用。例如,OpenAI 的图像细节设置可能显著改变 OM 决定何时观察。
Observer 还能看到它所审阅历史中的附件。OM 会在记录中保留 [Image #1: reference-board.png] 或 [File #1: floorplan.pdf] 等易读占位符,并将实际附件部分与文本一起转发。可能时,类似图像的 file 部分会升级为 Observer 的图像输入;非图像附件则作为文件部分转发,并使用规范化的 token 计数。普通 Thread 观察和批量 Resource 作用域观察都采用此方式。
ExtractorExtractor的直接链接
如果希望 OM 在观察结果之外持久化特定值,请使用 Extractor。当前任务、建议响应和 Thread 标题等内置值与自定义值使用相同的提取管道。
以下示例从观察结果中提取精简的用户资料:
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
添加 schema 会使 Extractor 以结构化输出后续请求的形式运行。没有 Schema 的 Extractor 是内联字符串 Extractor,直接在 Observer 或 Reflector 响应中发出。
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
默认情况下,OM 会在后续运行中向 Extractor 显示上一次提取的值。当 Observer 不应看到上一个值时,请设置 includePreviousExtraction: false。
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
当 Extractor 需要运行时上下文(例如活动 Memory 实例或请求上下文)时,请使用运行时 instructions 或 schema 函数:
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
从 Stream 读取提取值从 Stream 读取提取值的直接链接
OM 完成观察或反思时会发出 Extractor 结果。请从 Stream 中读取这两种完成数据部分:
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues 以各 Extractor 的 slug 为键。这两个结果字段都是可选的,某个 Extractor 失败不会移除其他成功 Extractor 的值。
data-om-observation-end 报告同步完成;data-om-buffering-end 报告已完成的后台工作。后者的 Extractor 元数据会立即持久化,但缓冲内容在激活前仍不可用。请检查 operationType,判断完成的工作是观察还是反思。
完整载荷请参阅 data-om-observation-end 和 data-om-buffering-end 参考表。
Working Memory 更新Working Memory 更新的直接链接
使用 observationalMemory.observation.manageWorkingMemory 可让 Observer 自动管理 Working Memory。主 Agent 在处理用户请求时不再需要调用 Working Memory Tool,因此更新不再依赖 Agent 是否记得调用它。
这也让 Working Memory 对提示词缓存更加友好。Working Memory 通常位于系统提示词中,因此更新会使提示词缓存失效。由 OM 管理的 Working Memory 默认将 workingMemory.useStateSignals 设为 true,从而将 Working Memory 移入状态信号。
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
此设置会添加 WorkingMemoryExtractor,并分别将 workingMemory.agentManaged 和 workingMemory.useStateSignals 的默认值设为 false 和 true。如果主 Agent 仍应接收 Working Memory Tool 和指令注入,请设置 workingMemory.agentManaged: true。
使用 onExtracted 可以在持久化前规范化自定义提取值或对其作出响应:
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
Extractor 失败会在 OM 标记中报告,不会阻止其他成功的 Extractor 值。完整 Extractor 结构请参阅 API 参考。
如果 Observer 模型只支持文本,或其 API 拒绝多模态输入,请将 observation.observeAttachments 设为 false,在附件到达 Observer 前丢弃它们。记录中仍保留易读占位符([Image #1: ...]、[File #1: ...]),所以即使不接收二进制载荷,Observer 仍可推断所分享的内容。该筛选也适用于包含图像或文件部分的 Tool 结果:
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
你也可以传入 mimeType glob 白名单(例如 ['image/*']),只转发 Observer 能处理的类型。或者设置 observeAttachments: 'auto',让 Mastra 根据 Provider 能力注册表决定:Observer 模型支持多模态输入时转发附件,否则丢弃;如果没有该模型的能力数据,则回退为 true。
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
压缩率通常在 5 倍到 40 倍之间。Observer 还会跟踪当前任务和建议响应,让 Agent 能从中断处继续。
启用 observation.threadTitle 后,当对话主题发生有意义的变化时,Observer 还可以建议一个简短 Thread 标题。Thread 标题生成需要显式启用,并会更新 Thread 元数据,因此 Mastra Code 等应用可以在 Thread 列表和状态 UI 中显示最新标题。
例如,使用 Playwright MCP 的 Agent 可能会为每个页面快照看到超过 50,000 个 token。使用 OM 后,Observer 会观察交互,并针对页面内容和已执行操作创建只有数百 token 的观察结果。Agent 无需携带每个原始快照,也能持续专注于任务。
反思反思的直接链接
当观察结果超过阈值(默认 40,000 token)时,Reflector 会对其进行浓缩、合并相关条目并反思其中的模式。
反思不会作为独立且持续增长的层累积。每次反思都会重写整个观察日志。Reflector 的输出成为新日志,新的观察结果则追加在其后。日志下次达到阈值时,Reflector 会重新处理所有内容,包括之前的反思。它会更积极地浓缩旧信息,同时保留近期细节。无论对话运行多久,Memory 都会保持在反思阈值附近的有限范围内。
最终形成一个三层系统:
- 近期消息:当前任务的精确对话历史
- 观察结果:Observer 所见内容的日志
- 反思:Memory 过长时经过浓缩的观察结果
上下文如何随时间变化上下文如何随时间变化的直接链接
使用默认设置时,上下文窗口不会无限增长,而是在观察与缩减的循环中波动:
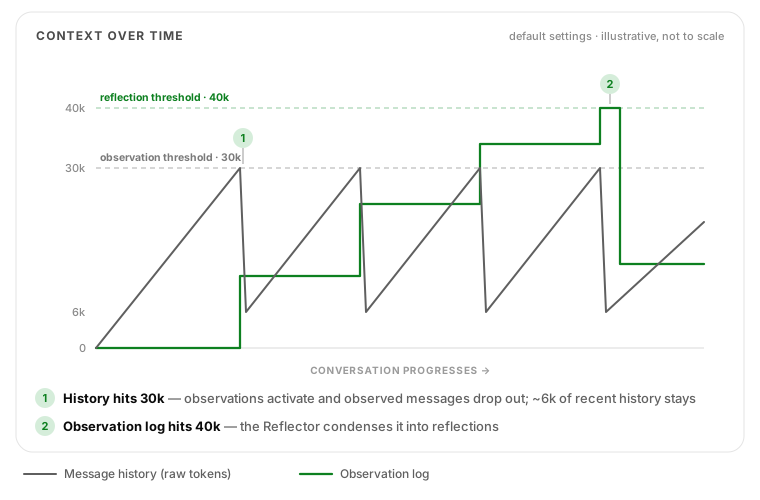
- 0 → 30k token:消息历史正常增长。Observer 每约 6k token(
bufferTokens: 0.2)在后台缓冲观察结果。 - 达到 30k:缓冲的观察结果立即激活。已观察消息从上下文窗口中移除,只保留约 6k token 的近期历史(
bufferActivation: 0.8会保留阈值的 20%)。被移除的约 24k token 消息,在通常 5–40 倍的压缩率下会变成约 1–5k token 的观察结果。 - 重复:历史从约 6k 再次增长到接近 30k,然后再次缩减。每个周期都向观察日志追加内容,其增长速度远慢于原始历史。
- 观察结果达到 40k:Reflector 根据当前观察结果和任何先前反思创建更小的日志。
在正常缓冲循环中,原始历史大致在 6k 到 30k token 之间波动。无论对话运行多久,观察日志都保持在约 40k token。这些是激活阈值而非硬性上限。如果后台缓冲跟不上,历史可能超过阈值,直到 blockAfter(默认 1.2)在约 36k token(反思约 48k)时强制执行同步观察,作为安全上限。
启用 shareTokenBudget 后,两项预算会合并。观察日志较小时,消息历史可以利用未使用的观察空间(默认设置下最高约 70k token),达到该空间后才触发观察。随着观察结果累积,窗口随之缩减。
检索模式检索模式的直接链接
普通 OM 会将消息压缩成观察结果,非常适合保持任务专注,但原始措辞也会消失。检索模式通过将每组观察结果与生成它的原始消息关联起来解决此问题。当 Agent 需要摘要中被压缩掉的精确措辞、Tool 输出或时间顺序时,可以调用 recall Tool 对源消息进行分页浏览。
仅浏览仅浏览的直接链接
设置 retrieval: true,启用用于浏览原始消息的 Recall Tool。无需 Vector Store。默认情况下,Recall Tool 可以浏览当前 Resource 的所有 Thread。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
使用语义搜索使用语义搜索的直接链接
设置 retrieval: { vector: true } 还可启用语义搜索。它会复用 Memory 实例上已配置的 Vector Store 和 Embedder:
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
配置向量搜索后,新的观察组会在缓冲时以及同步观察期间自动建立索引(触发后不等待结果,不会阻塞)。语义搜索返回匹配的观察组及其原始源消息 ID 范围,因此 Recall Tool 可以同时展示摘要 Memory 及其来源。
限制为当前 Thread限制为当前 Thread的直接链接
Recall Tool 的默认作用域是 'resource':Agent 可以列出 Thread、浏览其他 Thread,并搜索所有对话。设置 scope: 'thread' 可将 Agent 限制在当前 Thread:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
自定义 Recall 指导自定义 Recall 指导的直接链接
Mastra 会注入能够感知作用域的指令,教 Agent 何时搜索、列出 Thread 或读取特定 Thread。使用 instructions 可以在这些内置指令后追加应用特定的指导。内置指令永远不会被替换:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
这会让 Recall 特定指导附着于 Recall Tool,而不是 Agent 的全局指令,因此不会影响无关任务。
检索功能带来的能力检索功能带来的能力的直接链接
启用检索模式后,OM 会:
- 在每个观察组上存储一个指向其源消息的
range(例如startId:endId) - 让范围元数据在 Agent 上下文中保持可见,使 Agent 知道观察结果与哪些消息对应
- 注册一个 Agent 可调用的
recallTool,用于:- 对任意观察组范围后的原始消息进行分页浏览
- 按语义相似度搜索(
mode: "search"并提供query字符串);需要vector: true - 列出所有 Thread(
mode: "threads")、浏览其他 Thread(threadId),以及搜索所有 Thread(默认scope: 'resource') - 使用
scope: 'thread'时,将浏览和搜索限制在当前 Thread
完整 API(详细程度、部分索引、分页、跨 Thread 浏览和 token 限制)请参阅 Recall Tool 参考。
StudioStudio的直接链接
要查看实际工作方式,请打开 Studio 并进入启用了 OM 的 Agent。Memory 选项卡会显示:
- Token 进度条:消息和观察结果的当前 token 数量,以及各自距离阈值还有多远。将鼠标悬停在信息图标上,可查看 Observer 和 Reflector 使用的模型及阈值。
- 活动观察结果:当前观察日志以内联形式显示。如果存在更早的观察或反思记录,可展开“Previous observations”浏览。
- 后台处理:对话过程中,当 Agent 在后台处理时,会显示缓冲的观察块和反思状态。
Agent 进行观察或反思时,进度条会实时更新,显示已用时间和状态徽章。
模型模型的直接链接
Observer 和 Reflector 在后台运行。任何适用于 Mastra Model Router(provider/model)的模型都可以使用。未设置模型时,默认模型为 google/gemini-2.5-flash。
Mastra 建议使用上下文窗口较大(128K+ token)且速度足够快的模型,以便在后台运行时不拖慢你的操作。
如果不确定使用哪个模型,请从默认的 google/gemini-2.5-flash 开始。我们还成功测试了 openai/gpt-5-mini、anthropic/claude-haiku-4-5、deepseek/deepseek-reasoner、deepseek/deepseek-v4-pro、deepseek/deepseek-v4-flash、xai/grok-4-1-fast、qwen3 和 glm-4.7。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
有关为不同 Agent 使用不同模型的信息,请参阅模型配置。
google/gemini-2.5-flash 尤其擅长在长输出中保留细节。因此,即使达到最大压缩重试次数,Reflector 生成的反思也可能仍高于配置的 reflection.observationTokens 阈值。发生这种情况时,Reflector 会返回重试过程中产生的最小非退化候选结果,使循环终止,而不是无限运行。
如果希望 Reflector 更积极地压缩,请改用更容易浓缩内容的模型,例如 xai/grok-4-1-fast、deepseek/deepseek-v4-pro 或 deepseek/deepseek-v4-flash。你可以继续为 Observer 使用 google/gemini-2.5-flash,并为 Reflector 使用其他模型。请参阅每个 Agent 使用不同模型。
按 token 分层选择模型按 token 分层选择模型的直接链接
新增于:@mastra/memory@1.10.0
你可以使用 ModelByInputTokens,根据输入 token 数指定不同的 Observer 或 Reflector 模型。OM 会在运行时根据配置的 upTo 阈值选择匹配的模型层级。
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
upTo 键是包含边界值的上限。OM 会计算 Observer 或 Reflector 调用的实际输入 token 数,直接解析出匹配层级,并在运行中使用对应的具体模型。
如果输入超过配置的最大阈值,会抛出错误。请确保阈值覆盖所有可能的输入大小,或在最高层级使用上下文窗口足够大的模型。
作用域作用域的直接链接
Thread 作用域(默认)Thread 作用域(默认)的直接链接
每个 Thread 都有自己的观察结果。该作用域经过充分测试,非常适合作为通用 Memory 系统,尤其适合长周期 Agentic 使用场景。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
Thread 作用域要求调用 Agent 时提供有效的 threadId。如果缺少 threadId,Observational Memory 会抛出错误。这可以防止多个 Thread 悄然共享一条观察记录,从而避免数据库死锁。
Resource 作用域(实验性)Resource 作用域(实验性)的直接链接
某个 Resource(通常是用户)的所有 Thread 会共享观察结果,从而实现跨对话 Memory。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'resource',
    },
  },
})
Resource 作用域可以正常工作,但在验证多个同时进行的 Thread 之间是否能够遵循任务并保持连续性之前,它仍标记为实验性。 目前,你可能需要调整系统提示词,防止一个 Thread 继续执行另一个 Thread 已开始但尚未完成的工作。
这是因为在 Resource 作用域中,每个 Thread 都是该 Resource 的_所有_ Thread 的一个视角。
对你的使用场景而言,这可能不是问题,实际效果会因情况而异。
在 Resource 作用域中,所有 Thread 中尚未观察的消息会一起处理。对于已有大量 Thread 的用户,这可能很慢。现有应用请使用 Thread 作用域。
Token 预算Token 预算的直接链接
OM 使用 token 阈值决定何时观察和反思。详情请参阅 token 预算配置。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
Token 计数缓存Token 计数缓存的直接链接
OM 会在消息元数据中缓存 token 估算结果,减少阈值检查和缓冲决策期间的重复计数。
- 每个部分的估算结果存储在
part.providerMetadata.mastra中;后续处理时,如果缓存版本/tokenizer 来源匹配,就会复用。 - 对于只有字符串内容(没有部分)的消息,OM 使用消息级元数据作为后备缓存。
- 消息和对话开销仍会在每次处理时重新计算。缓存只存储载荷估算结果,因此计数语义保持不变。
data-*和reasoning部分仍会跳过,也不会缓存。
调用方为文件部分提供 token 估算调用方为文件部分提供 token 估算的直接链接
你可以使用 providerMetadata.mastra.tokenEstimate 直接为 image 或 file 部分附加 token 估算值。Token Counter 会原样采用该值并跳过自身估算:
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
tokenEstimate 对象采用 Token Counter 内部缓存估算所使用的相同结构:
v:缓存 Schema 版本。设为0。调用方提供的条目不受框架版本检查影响,因此不会读取该值。source:缓存来源标记。必须为'client'。它告诉 Token Counter 该条目具有权威性,应原样采用而非重新计算或覆盖。key:内容指纹位置。设为'client'。框架条目在此使用内容哈希,以便载荷变化时使缓存失效;'client'哨兵可让调用方估算在多次写入间保持稳定。tokens:要使用的 token 数。必须是有限的非负数。
其他注意事项:
- 估算只适用于
image和file部分。即使text和tool-invocation部分携带tokenEstimate,也始终按正常方式计数。
异步缓冲异步缓冲的直接链接
如果不使用异步缓冲,达到消息阈值时 Observer 会同步运行,Agent 会在对话中途暂停,等待 Observer 的 LLM 调用完成。使用异步缓冲(默认启用)时,观察结果会随对话增长在后台预先计算。达到阈值时,缓冲的观察结果会立即激活,不会暂停。
工作原理工作原理的直接链接
Agent 对话时,消息 token 不断累积。每隔一定数量(bufferTokens),后台 Observer 调用就会运行且不阻塞 Agent。每次调用都会生成一“块”观察结果,并存入缓冲区。
消息 token 达到 messageTokens 阈值时,缓冲块会激活:观察结果移入活动观察日志,对应的原始消息从上下文窗口移除。Agent 不会暂停。
缓冲观察结果还包含续接提示、建议的下一条响应和当前任务,因此激活缩小上下文窗口后,主 Agent 仍能保持对话连续性。
如果 Agent 生成消息的速度快于 Observer 的处理速度,blockAfter 安全阈值会强制执行同步观察,作为最后保障。缓冲激活仍会保留最小的剩余上下文(约 1k token 与配置的保留下限两者中的较小值)。
反思的工作方式类似:当观察结果达到反思阈值的一定比例时,Reflector 会在后台运行。
设置设置的直接链接
| 设置 | 默认值 | 控制内容 |
|---|---|---|
observation.bufferTokens | 0.2 | 缓冲频率。0.2 表示每达到 messageTokens 的 20% 就缓冲一次。默认阈值为 30k,因此约每 6k token 一次。也可以是绝对 token 数(例如 5000)。 |
observation.bufferActivation | 0.8 | 激活时清理消息窗口的程度。0.8 表示移除足够多的消息,使剩余内容仅占 messageTokens 的 20%。较小的值会保留更多消息历史。 |
observation.blockAfter | 1.2 | 缓冲跟不上时的安全保障。大于等于 1 且小于 100 的值会乘以 messageTokens:使用 1.2 时,会在 36k token(1.2 × 30k)强制同步观察。100 或以上的值是绝对 token 数(例如 50_000)。 |
activateAfterIdle | 无 | 空闲一段时间后强制激活缓冲观察结果,即使尚未达到 observation.messageTokens。接受数值毫秒(如 300_000)、"5m" 或 "1hr" 等时长字符串,或使用 "auto" 获取能够感知 Provider 的提示词缓存 TTL。 |
activateOnProviderChange | false | 如果下一步使用的 provider/model 与生成最新助手步骤的模型不同,则强制激活缓冲观察结果。当切换 Provider 或模型会使提示词缓存失效时,请使用此项。 |
reflection.bufferActivation | 0.5 | 何时开始后台反思。0.5 表示观察结果达到 observationTokens 阈值的 50% 时开始反思。 |
reflection.activateAfterIdle | 无 | 为缓冲反思启用空闲激活。反思不会继承顶层 activateAfterIdle。 |
reflection.activateOnProviderChange | false | 为缓冲反思启用 Provider 变更激活。反思不会继承顶层 activateOnProviderChange。 |
reflection.blockAfter | 1.2 | 反思的安全阈值,逻辑与观察相同。 |
如果依赖提示词缓存,请将 activateAfterIdle 设为 "auto" 或特定的缓存 TTL。这样,当 Thread 空闲时间足以使缓存过期后,下一个请求可以先激活缓冲观察结果,再发送更小的压缩上下文窗口。
使用 "auto" 时,Mastra 会根据当前模型 Provider 选择空闲激活 TTL:
| Provider | 自动 TTL |
|---|---|
| Anthropic、OpenRouter、未知 Provider、xAI | 5 分钟 |
| DeepSeek | 1 小时 |
| Google Gemini | 24 小时 |
| Groq | 2 小时 |
使用 providerOptions.openai.promptCacheRetention: "24h" 的 OpenAI | 1 小时 |
使用 providerOptions.openai.promptCacheRetention: "in_memory" 的 OpenAI | 5 分钟 |
通过 OpenAI 使用的 gpt-4*、gpt-5、gpt-5-* 以及 gpt-5.1 到 gpt-5.4(包括带 - 后缀的变体) | 5 分钟 |
| 其他 OpenAI 模型 | 1 小时 |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
使用 "auto" 时,它会根据活动 Provider 的提示词缓存行为激活缓冲观察结果,让下一次未缓存的提示词使用压缩观察结果,而不是更大的原始消息窗口。如果希望使用固定 5 分钟 TTL,请使用 "5m" 或 300_000。
在 Thread 中途更换模型或 Provider 会使提示词缓存失效。如果 Agent 可以中途切换 Provider 或模型,activateOnProviderChange: true 会在新 Provider 运行前强制激活缓冲观察结果,避免向无法复用之前提示词缓存的 Provider 发送大型原始窗口。
禁用禁用的直接链接
要禁用异步缓冲并改用同步观察/反思:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
设置 bufferTokens: false 会同时禁用观察和反思的异步缓冲。完整 API 请参阅异步缓冲配置。
scope: 'resource' 不支持异步缓冲。Resource 作用域会自动禁用它。
Observer 上下文优化Observer 上下文优化的直接链接
默认情况下,Observer 处理新消息时会接收完整观察历史作为上下文。它还会接收先前的 current-task 和 suggested-response 元数据(如果存在),即使观察上下文被截断,也能保持方向。对于观察结果不断增长的长时间对话,可以选择启用上下文优化,以降低 Observer 输入成本。
设置 observation.previousObserverTokens,可以限制发送给 Observer 的先前观察结果 token 数。观察结果会从尾部截断,保留最近的条目。如果有缓冲反思待处理,已反思的行会在截断前自动替换为反思摘要。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: 2000→ 默认值。保留约 2k token 的近期观察结果。previousObserverTokens: 0→ 完全省略先前观察结果。previousObserverTokens: false→ 禁用截断,保留完整的先前观察结果。
迁移现有 Thread迁移现有 Thread的直接链接
无需手动迁移。OM 会读取现有消息,并在超过阈值时延迟观察。
- Thread 作用域:Thread 首次超过
observation.messageTokens时,Observer 会处理积压消息。 - Resource 作用域:某个 Resource 的所有 Thread 中尚未观察的消息会一起处理。对于已有大量 Thread 的用户,这可能耗费很长时间。
OM 与其他 Memory 功能的比较OM 与其他 Memory 功能的比较的直接链接
- 消息历史:当前对话的高保真记录
- Working Memory:用于用户偏好、姓名和目标的小型结构化状态(JSON 或 Markdown)
- Semantic Recall:基于 RAG 检索相关历史消息
- 多用户 Thread:多人共享同一 Thread 时,OM 如何将事实归属于各个用户
如果你使用 Working Memory 存储对话摘要或随时间增长的持续状态,OM 更合适。Working Memory 适合小型结构化数据,OM 适合长期运行的事件日志。OM 还会自动管理消息历史;messageTokens 设置控制在运行观察前保留多少原始历史。
实际而言,OM 可以同时取代 Working Memory 和消息历史,并且比 Semantic Recall 更准确、成本更低。
相关内容相关内容的直接链接
- Observational Memory 参考文档
- Memory 概览
- 消息历史
- Memory Processor
- Mastra Code:使用 Observational Memory 的编程 Agent
- 📹 Mastra Processor 与 Observational Memory 研讨会